Verifique um limite de bytes UTF-8 com o contador de caracteres
Veja nas capturas como verificar o limite de 24 bytes UTF-8 de um campo CSV, extrair o início sem cortar o emoji e encurtar o texto para preservá-lo.
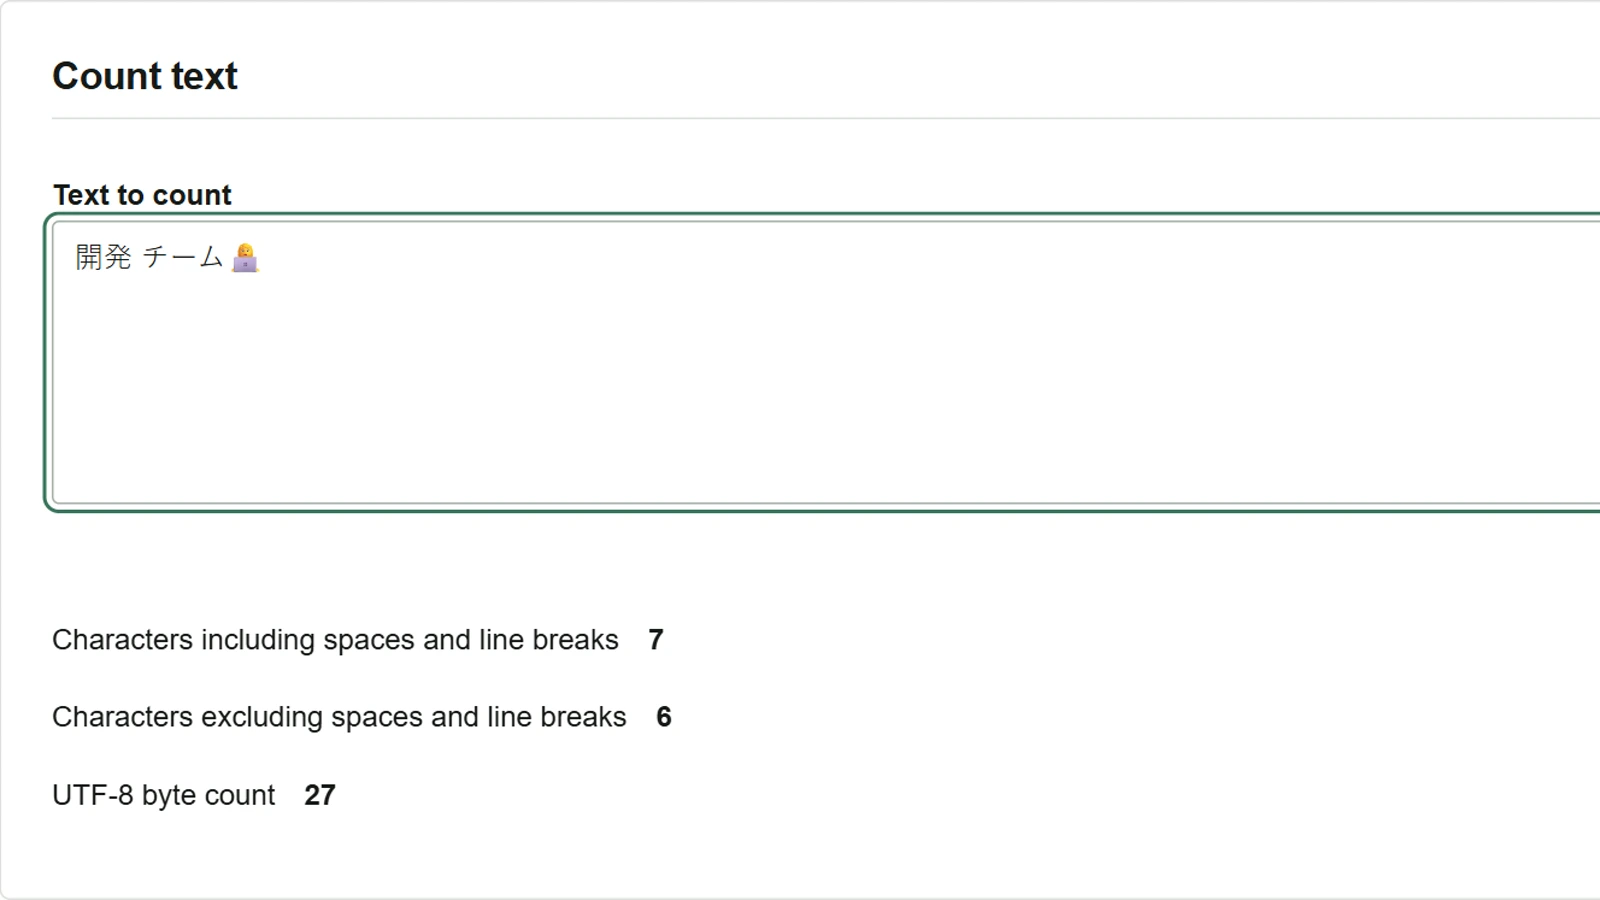
Imagine que um importador de CSV aceite nomes de campo com até 24 bytes em UTF-8. O nome proposto 開発 チーム👩💻 tem sete caracteres com o espaço, mas ocupa 27 bytes. Abra o contador de caracteres para ver que parte cabe antes de editar o texto.
Encontre o início que cabe em 24 bytes
- Cole
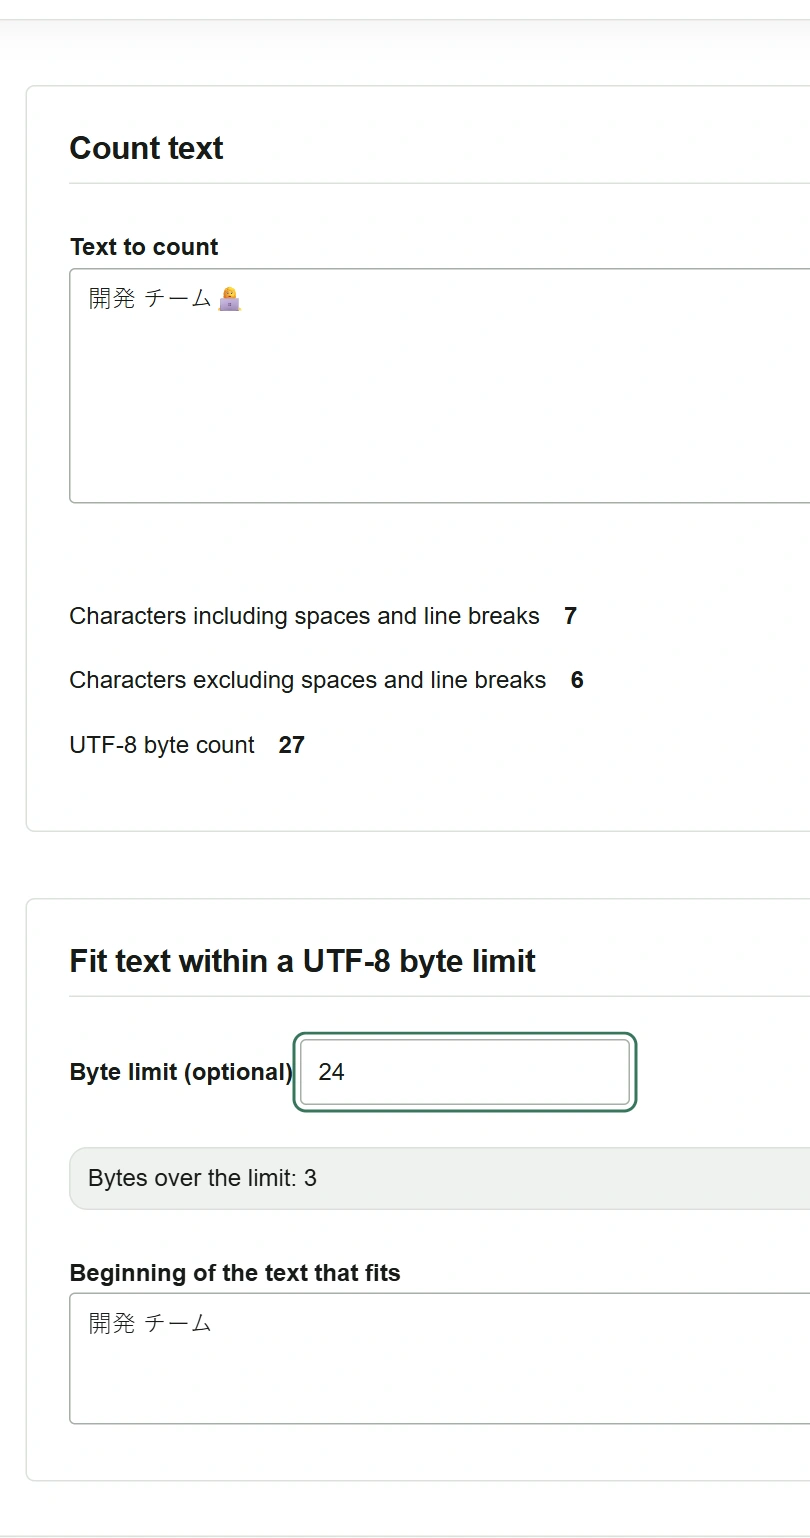
開発 チーム👩💻em Texto a contar. Confira se aparecem sete caracteres com o espaço, seis sem ele e 27 bytes em UTF-8. - Digite
24em Limite de bytes (opcional). - O texto original passa três bytes do limite. O campo de resultado mostra
開発 チーム. Para usar esse trecho, selecione-o e copie-o. O texto original com o emoji continua no campo de entrada.
Encurte o texto e mantenha o emoji
- Mantenha o limite em
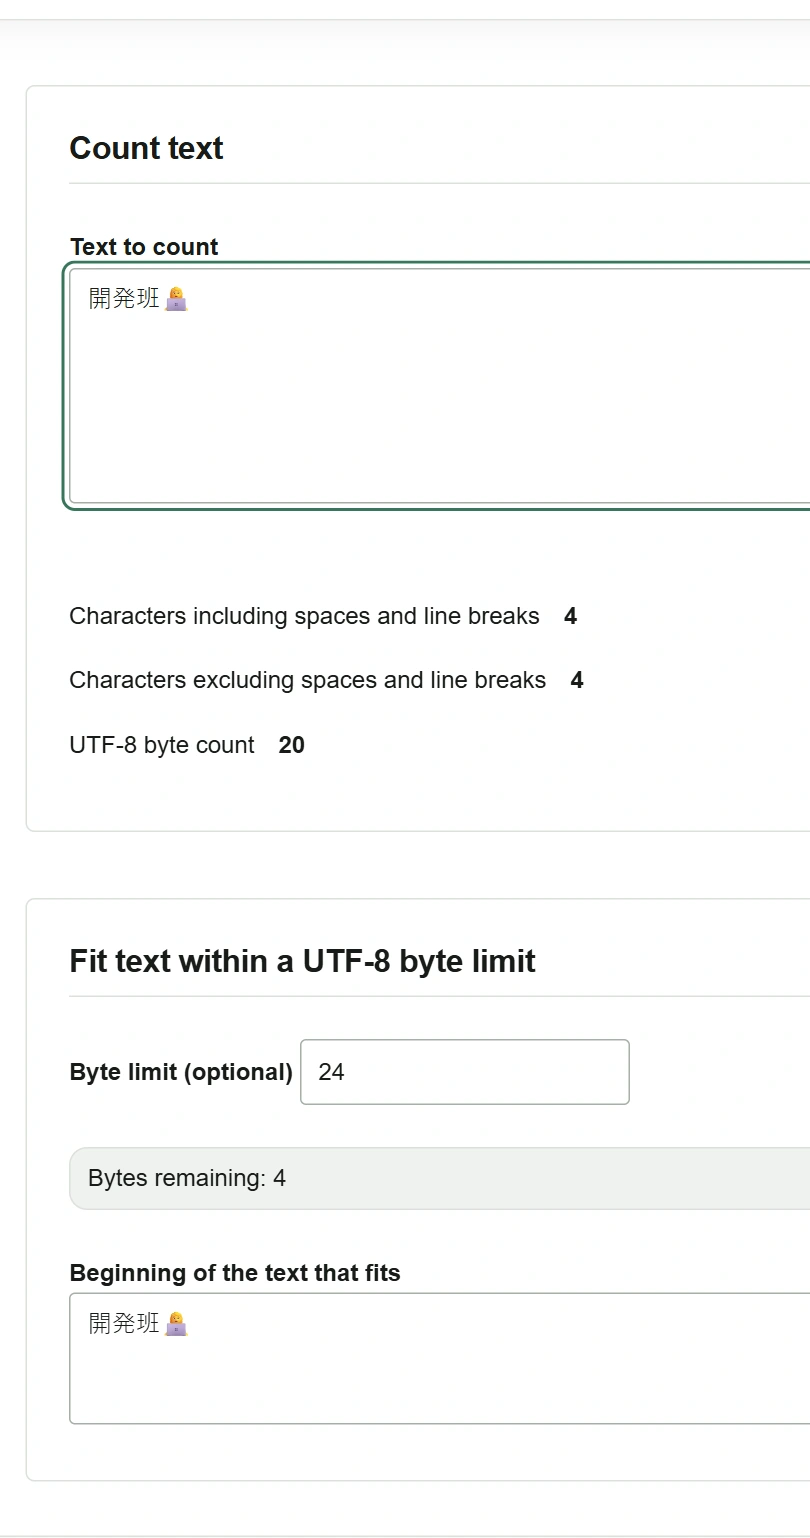
24e substitua o texto do primeiro campo por開発班👩💻. - O texto revisado ocupa 20 bytes, com quatro de sobra. O campo de resultado mostra o texto completo. Copie e cole no destino e confira se ele aceita o texto.
Aqui medimos o valor do campo em UTF-8. Para incluir os delimitadores do CSV e as aspas adicionadas na exportação, meça o arquivo salvo. As quebras de linha coladas no campo contam como um byte (LF), enquanto no arquivo salvo com CRLF cada quebra ocupa dois bytes. Siga as regras de importação se a codificação ou a contagem de caracteres for diferente.