Vérifier une limite d’octets UTF-8 avec le compteur de caractères
Les captures montrent comment vérifier une limite de 24 octets UTF-8 pour un champ CSV, trouver le début qui tient sans couper l’emoji et raccourcir le texte pour le garder.
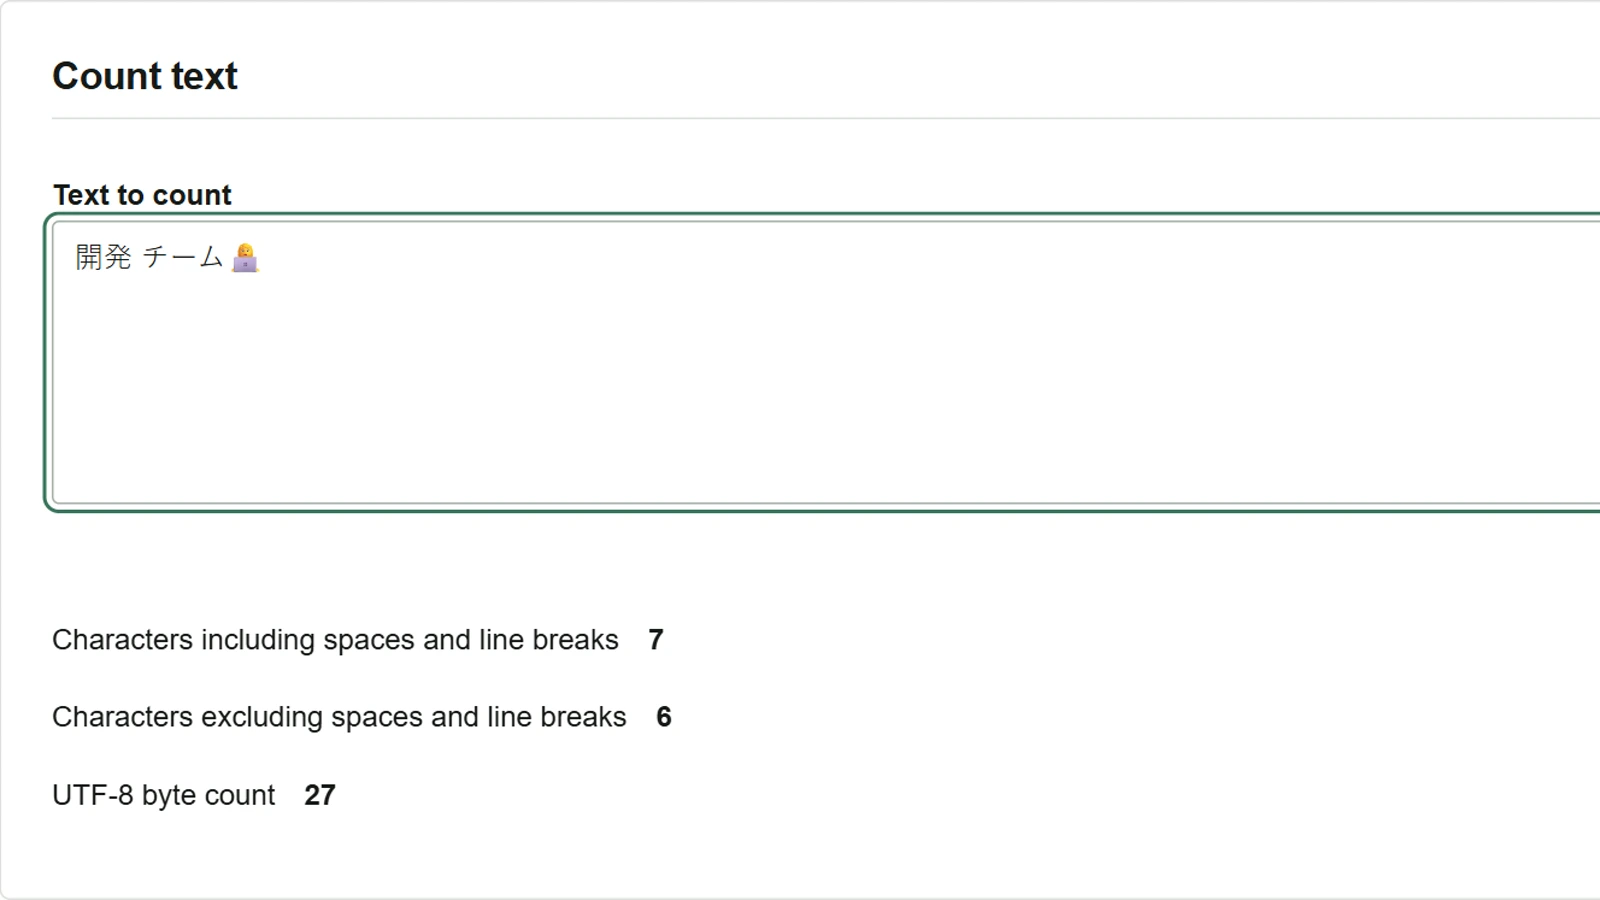
Supposons qu’un logiciel d’import CSV accepte des noms de champ de 24 octets UTF-8 au maximum. Le nom envisagé 開発 チーム👩💻 comporte sept caractères en comptant l’espace, mais occupe 27 octets. Ouvrez le compteur de caractères pour voir quelle partie tient dans la limite avant de modifier le texte.
Trouver le début qui tient dans 24 octets
- Collez
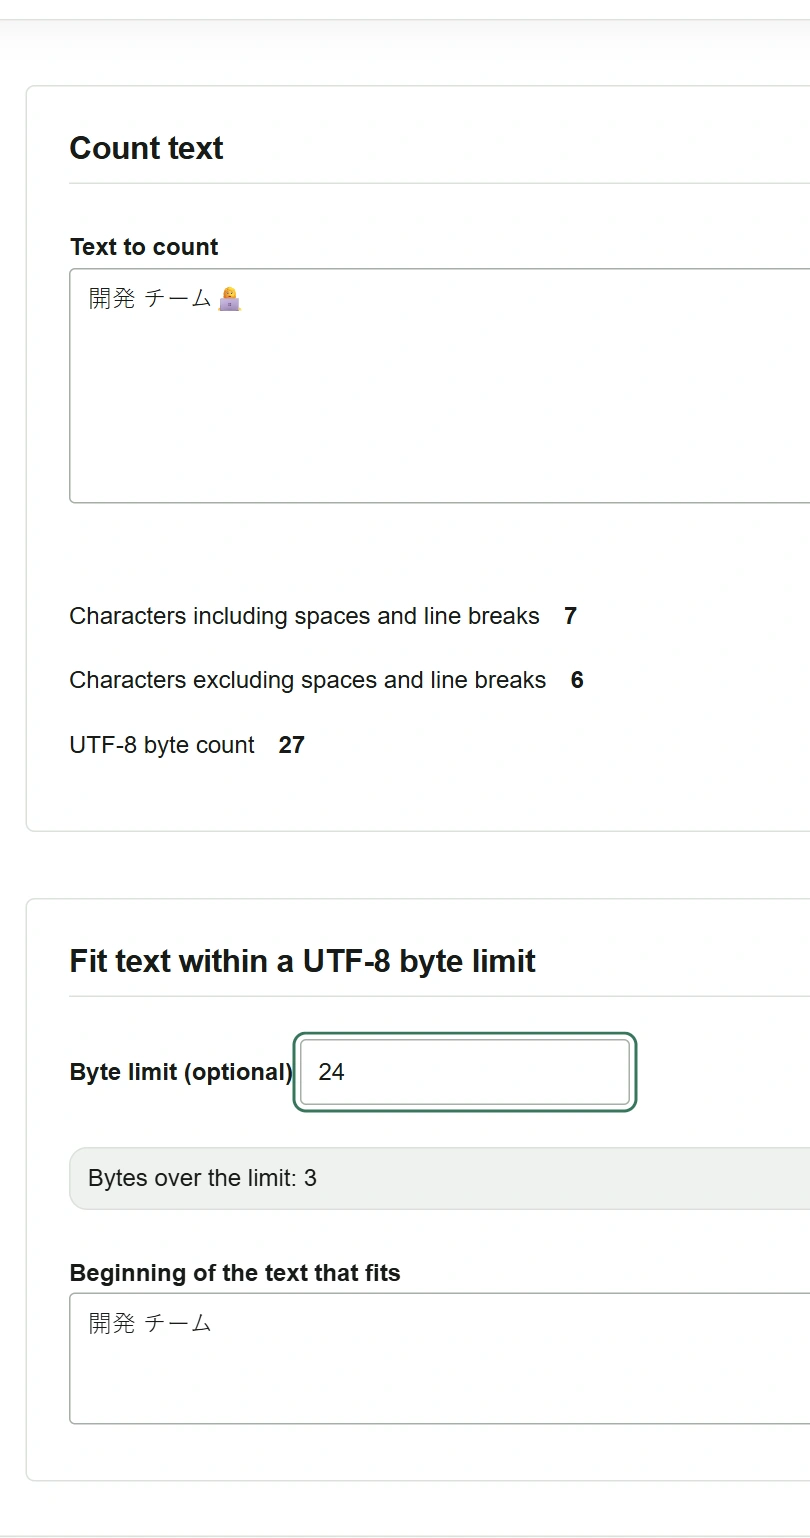
開発 チーム👩💻dans Texte à compter. Vérifiez que le résultat indique sept caractères avec l’espace, six sans et 27 octets UTF-8. - Saisissez
24dans Limite d’octets (facultative). - Le texte d’origine dépasse la limite de trois octets. Le champ de résultat affiche
開発 チーム. Pour l’utiliser, sélectionnez-le et copiez-le. Le texte d’origine avec l’emoji reste dans le champ de saisie.
Raccourcir le texte en gardant l’emoji
- Gardez la limite à
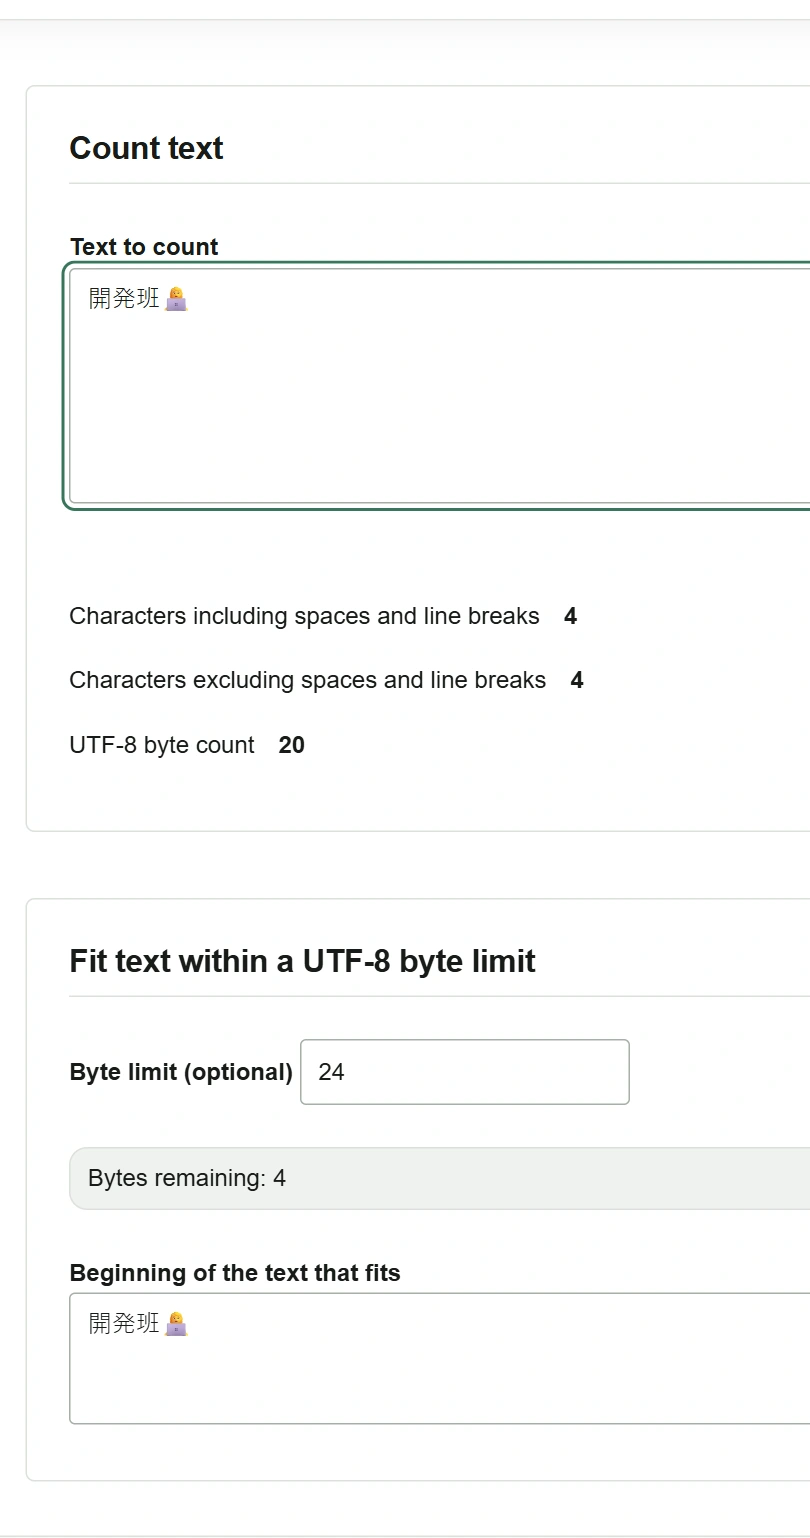
24et remplacez la saisie du premier champ par開発班👩💻. - Le texte révisé occupe 20 octets et en laisse quatre disponibles. Le champ de résultat affiche le texte entier. Copiez-le à l’endroit voulu et vérifiez que le logiciel l’accepte.
On mesure ici la valeur du champ en UTF-8. Pour compter les séparateurs CSV et les guillemets ajoutés à l’export, mesurez le fichier enregistré. Un saut de ligne collé dans le champ correspond à un octet (LF). Dans un fichier enregistré en CRLF, il en occupe deux. Si le logiciel d’import utilise un autre encodage ou mode de comptage, suivez ses règles.