Ein UTF-8-Byte-Limit mit dem Zeichenzähler prüfen
Die Bildschirmfotos zeigen, wie du ein UTF-8-Limit von 24 Bytes für einen CSV-Feldnamen prüfst, den passenden Anfang ohne Emoji-Trennung findest und den Text kürzt.
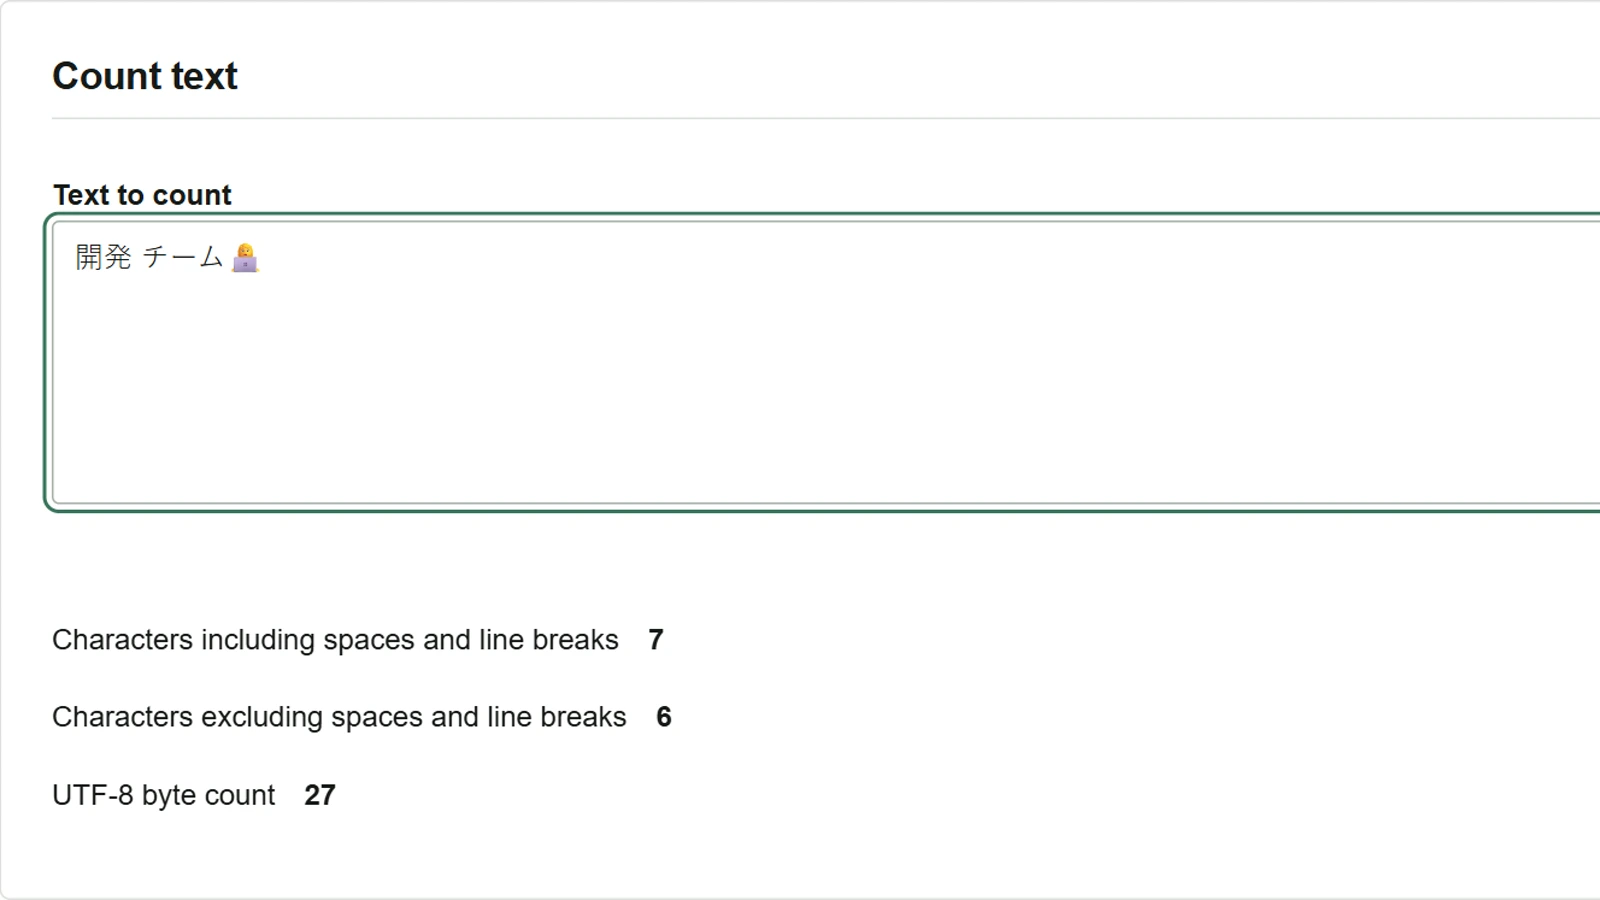
Angenommen, beim CSV-Import darf ein Feldname höchstens 24 UTF-8-Bytes belegen. Der Vorschlag 開発 チーム👩💻 hat mit Leerzeichen sieben Zeichen, belegt aber 27 Bytes. Öffne den Zeichenzähler, um vor der Bearbeitung zu prüfen, wie viel vom Text hineinpasst.
Den Anfang ermitteln, der in 24 Bytes passt
- Füge
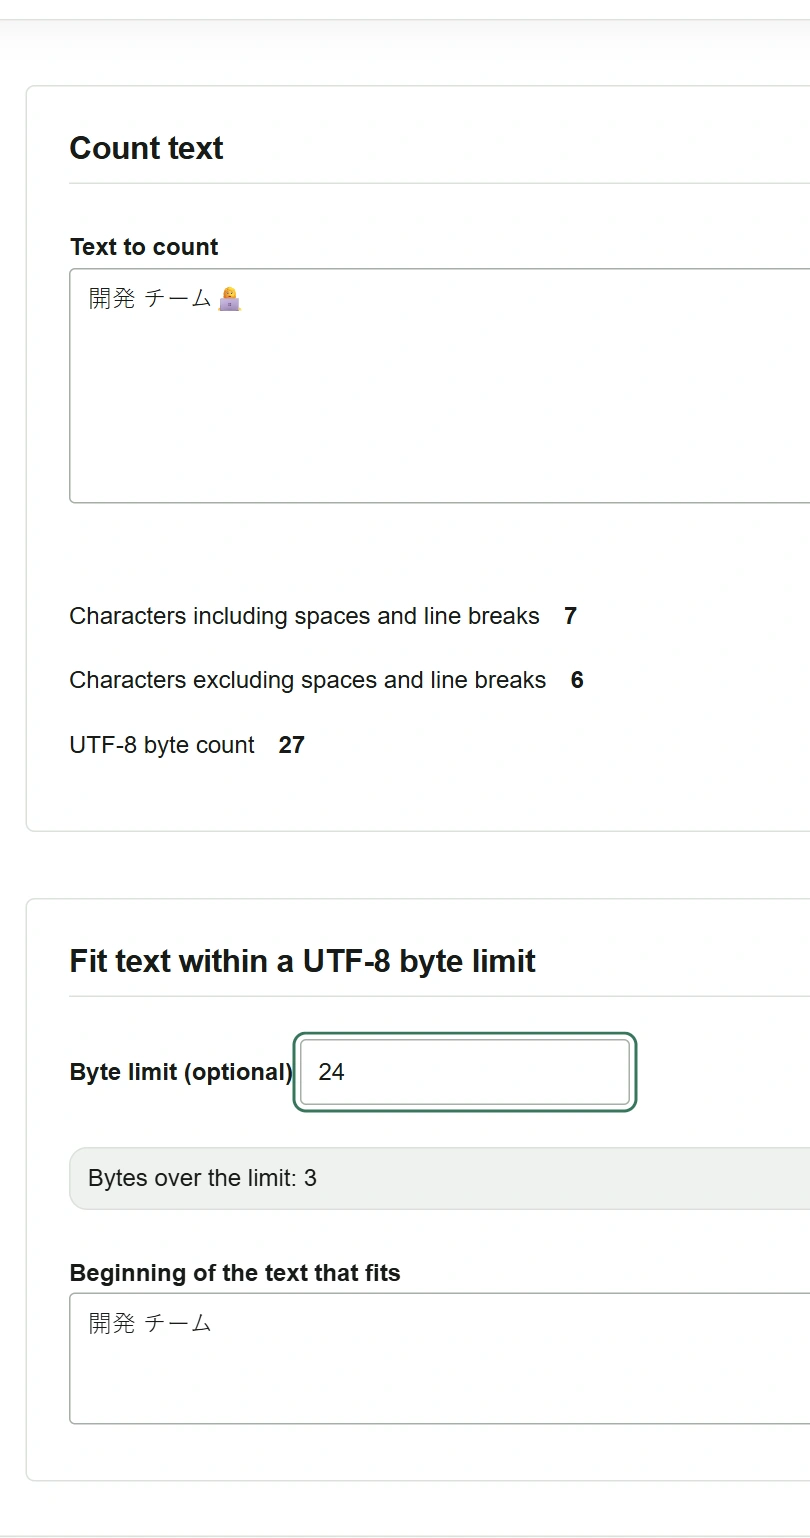
開発 チーム👩💻in Zu zählender Text ein. Prüfe, ob sieben Zeichen mit Leerzeichen, sechs ohne Leerzeichen und 27 UTF-8-Bytes angezeigt werden. - Gib in Bytegrenze (optional) den Wert
24ein. - Der ursprüngliche Text liegt drei Bytes über dem Limit. Das Ergebnisfeld zeigt
開発 チーム. Um diesen Teil zu verwenden, markiere und kopiere ihn. Der ursprüngliche Text mit Emoji bleibt im Eingabefeld.
Den Text kürzen und das Emoji behalten
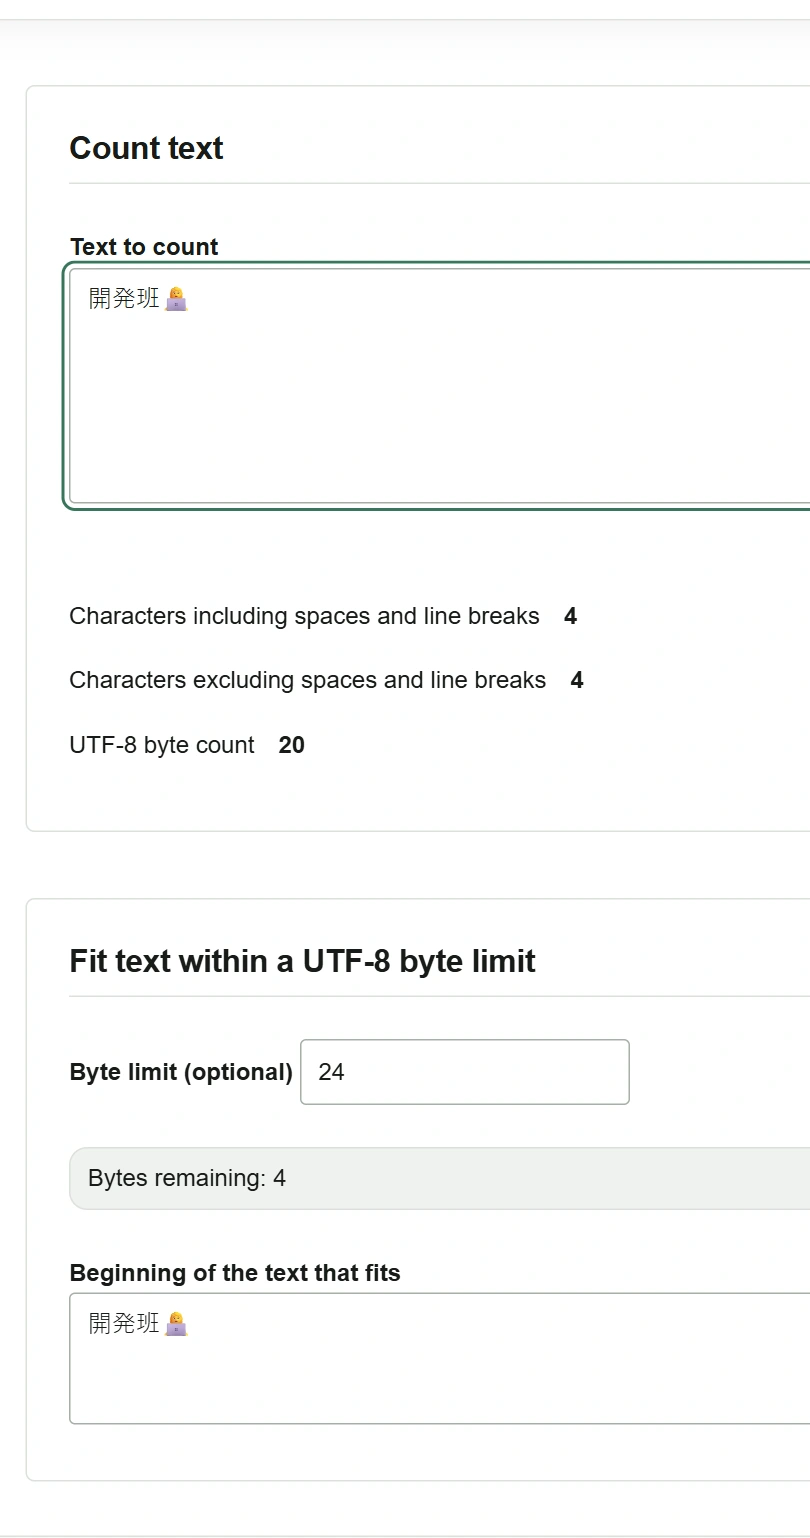
- Lass das Limit bei
24und ersetze den Text im ersten Feld durch開発班👩💻. - Der geänderte Text belegt 20 Bytes. Vier Bytes sind noch frei, und das Ergebnisfeld zeigt den ganzen Text. Kopiere ihn an die Zielstelle und prüfe, ob er dort angenommen wird.
Hier wird der Feldwert in UTF-8 gemessen. Für die Größe der gesamten CSV samt Trennzeichen und beim Export hinzugefügten Anführungszeichen miss die gespeicherte Datei. Eingefügte Zeilenumbrüche belegen als LF ein Byte, in mit CRLF gespeicherten Dateien dagegen zwei Bytes pro Umbruch. Verwendet der Import eine andere Kodierung oder Zählweise, gelten dessen Vorgaben.