UTF-8 bájtkorlát ellenőrzése a karakterszámlálóval
A képernyőképek bemutatják, hogyan ellenőrizd egy CSV-mezőnév 24 bájtos UTF-8-korlátját, találd meg a beleférő kezdőrészt az emoji megszakítása nélkül, és rövidítsd a szöveget.
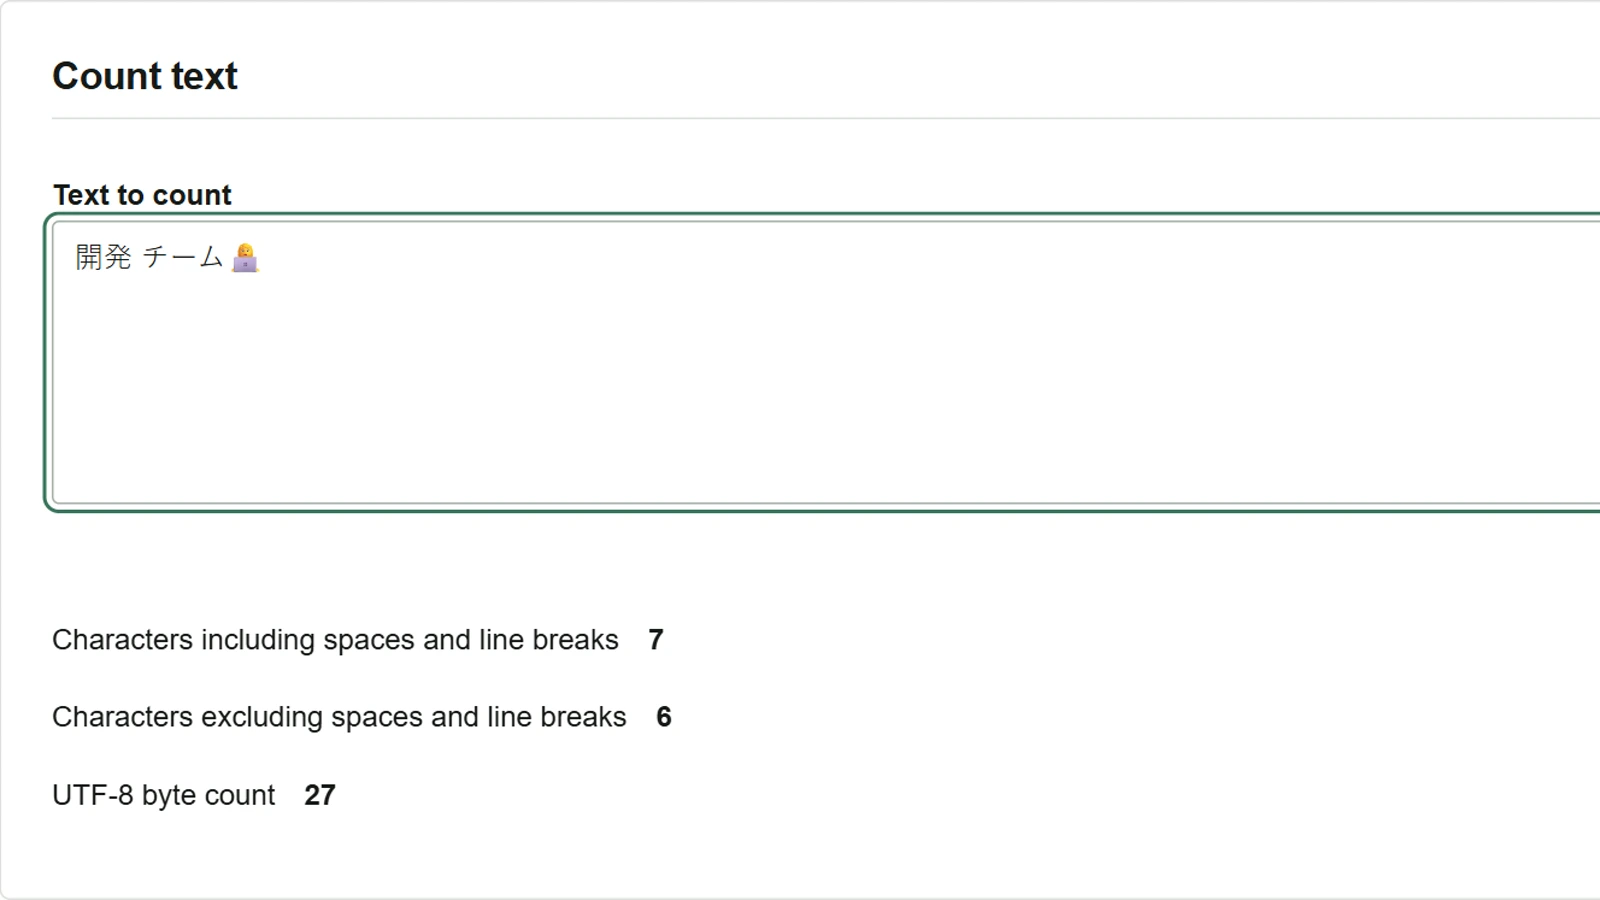
Tegyük fel, hogy a CSV-importáló legfeljebb 24 UTF-8-bájtot enged meg a mezőnévben. A javasolt 開発 チーム👩💻 a szóközzel együtt hét karakter, mégis 27 bájtot foglal. Nyisd meg a karakterszámláló eszközt, és a módosítás előtt nézd meg, mennyi fér bele.
Keresd meg a 24 bájtba beleférő kezdőrészt
- Illeszd be a(z)
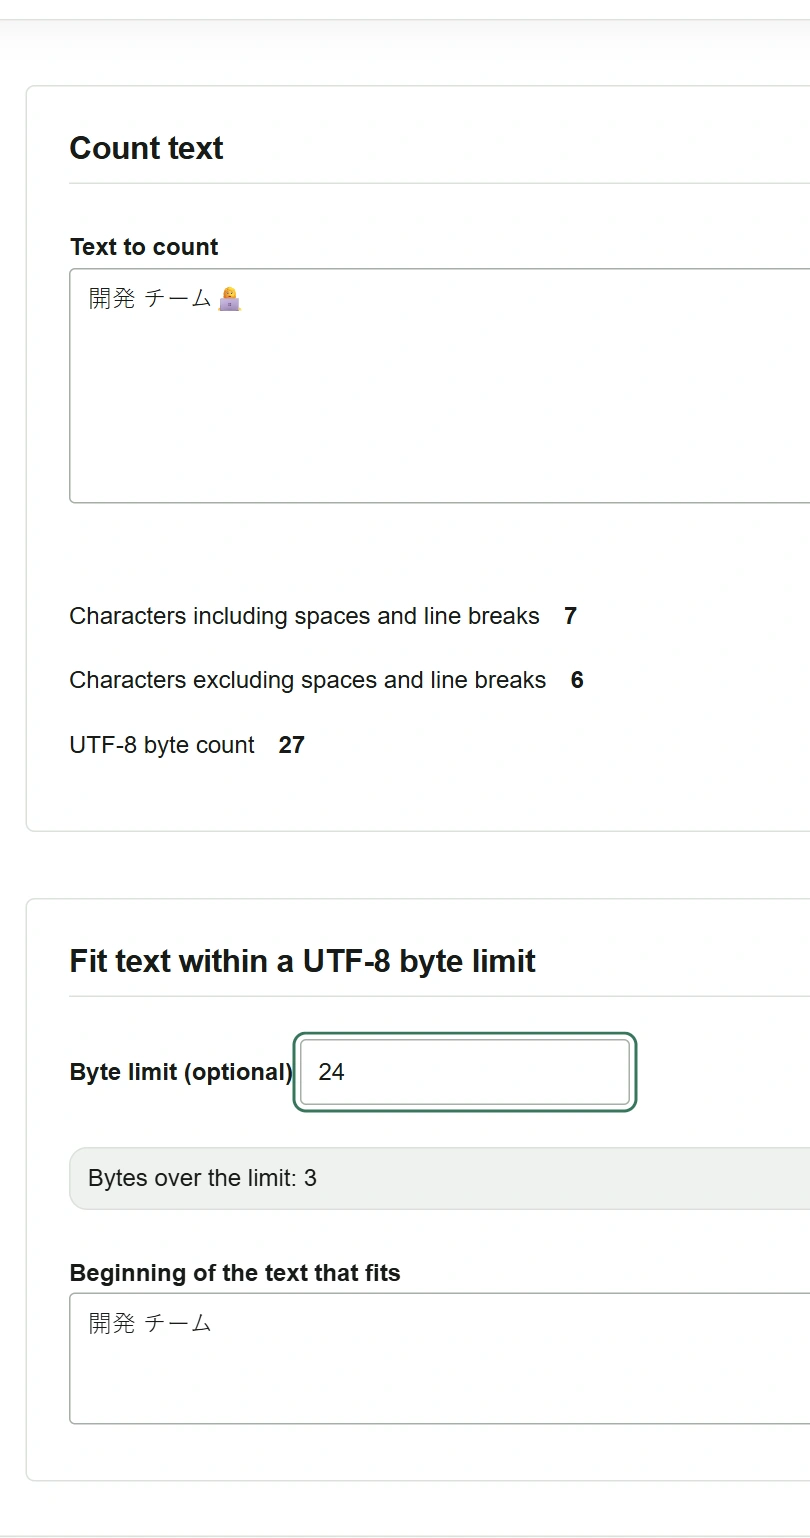
開発 チーム👩💻szöveget a(z) Megszámolandó szöveg mezőbe. Ellenőrizd a hét karaktert szóközzel, a hatot anélkül és a 27 UTF-8-bájtot. - Írd be a
24értéket a(z) Bájtkorlát (nem kötelező) mezőbe. - Az eredeti szöveg három bájttal túllépi a korlátot. Az eredménymezőben
開発 チームjelenik meg. Ha ezt szeretnéd használni, jelöld ki és másold ki. Az eredeti, emojit tartalmazó szöveg a beviteli mezőben marad.
Rövidítsd le a szöveget, hogy az emoji is beleférjen
- Hagyd a korlátot
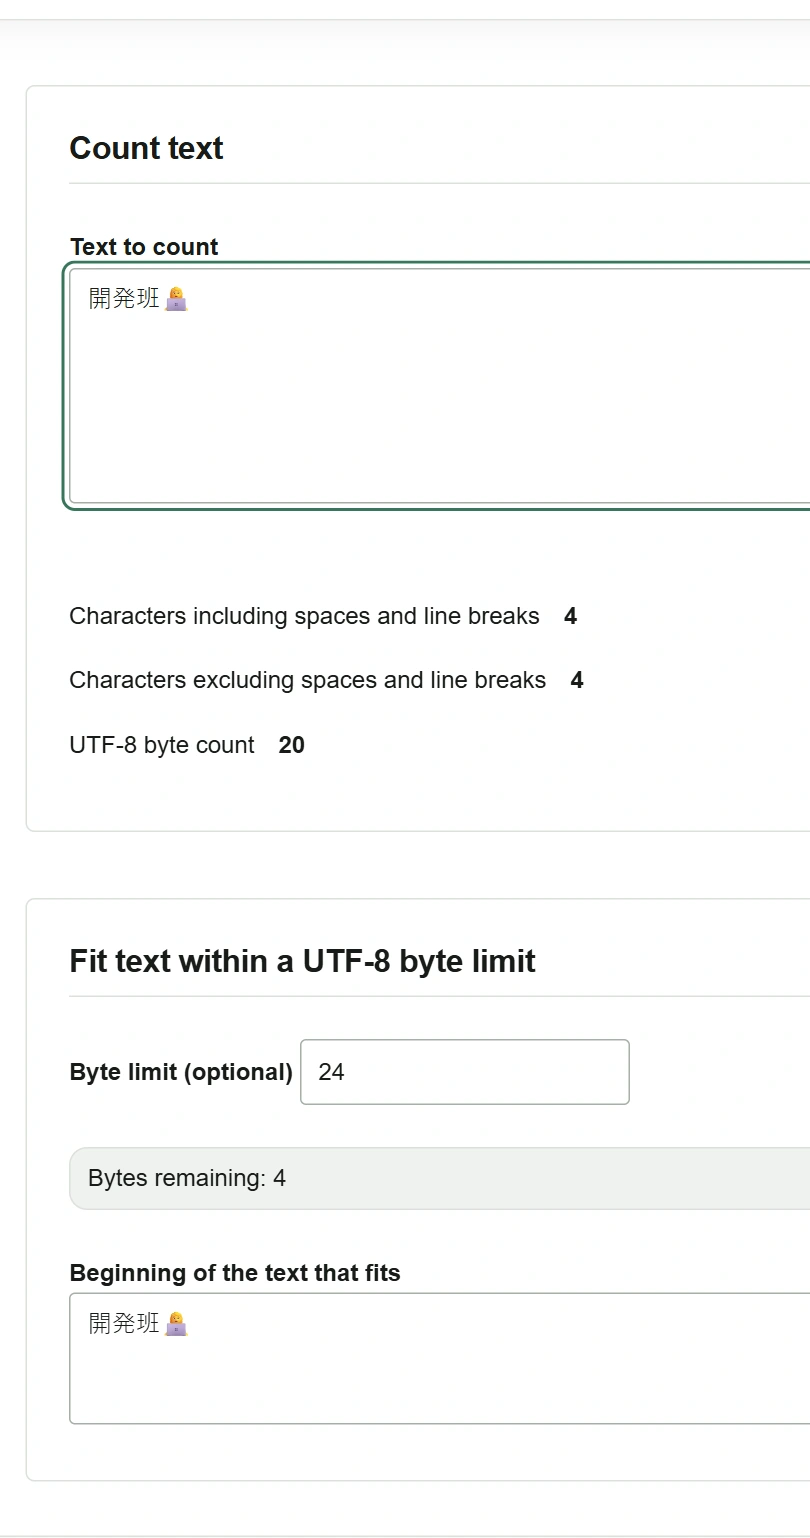
24-en, és cseréld le az első mező tartalmát erre:開発班👩💻. - A módosított szöveg 20 bájt, így négy marad szabadon. Az eredménymező a teljes szöveget mutatja. Másold a célhelyre, és ellenőrizd, hogy ott elfogadják-e.
A példában az UTF-8 kódolású mezőértéket mérjük. Ha a CSV-elválasztók és az exportáláskor hozzáadott idézőjelek is számítanak, a mentett fájl méretét ellenőrizd. A mezőbe beillesztett sortörés LF-ként egy bájtot, a CRLF-fel mentett fájlban két bájtot foglal. Ha az importáló eltérő kódolást vagy számlálási módot használ, kövesd annak szabályait.