文字数カウンターで確認する UTF-8 のバイト上限
CSVの項目名がUTF-8で24バイトまでという例で、空白あり・なしの文字数とバイト数の違いを確認する。絵文字を分断せずに先頭を取り出し、文面を短くして上限に収める操作も画面付きで紹介する。
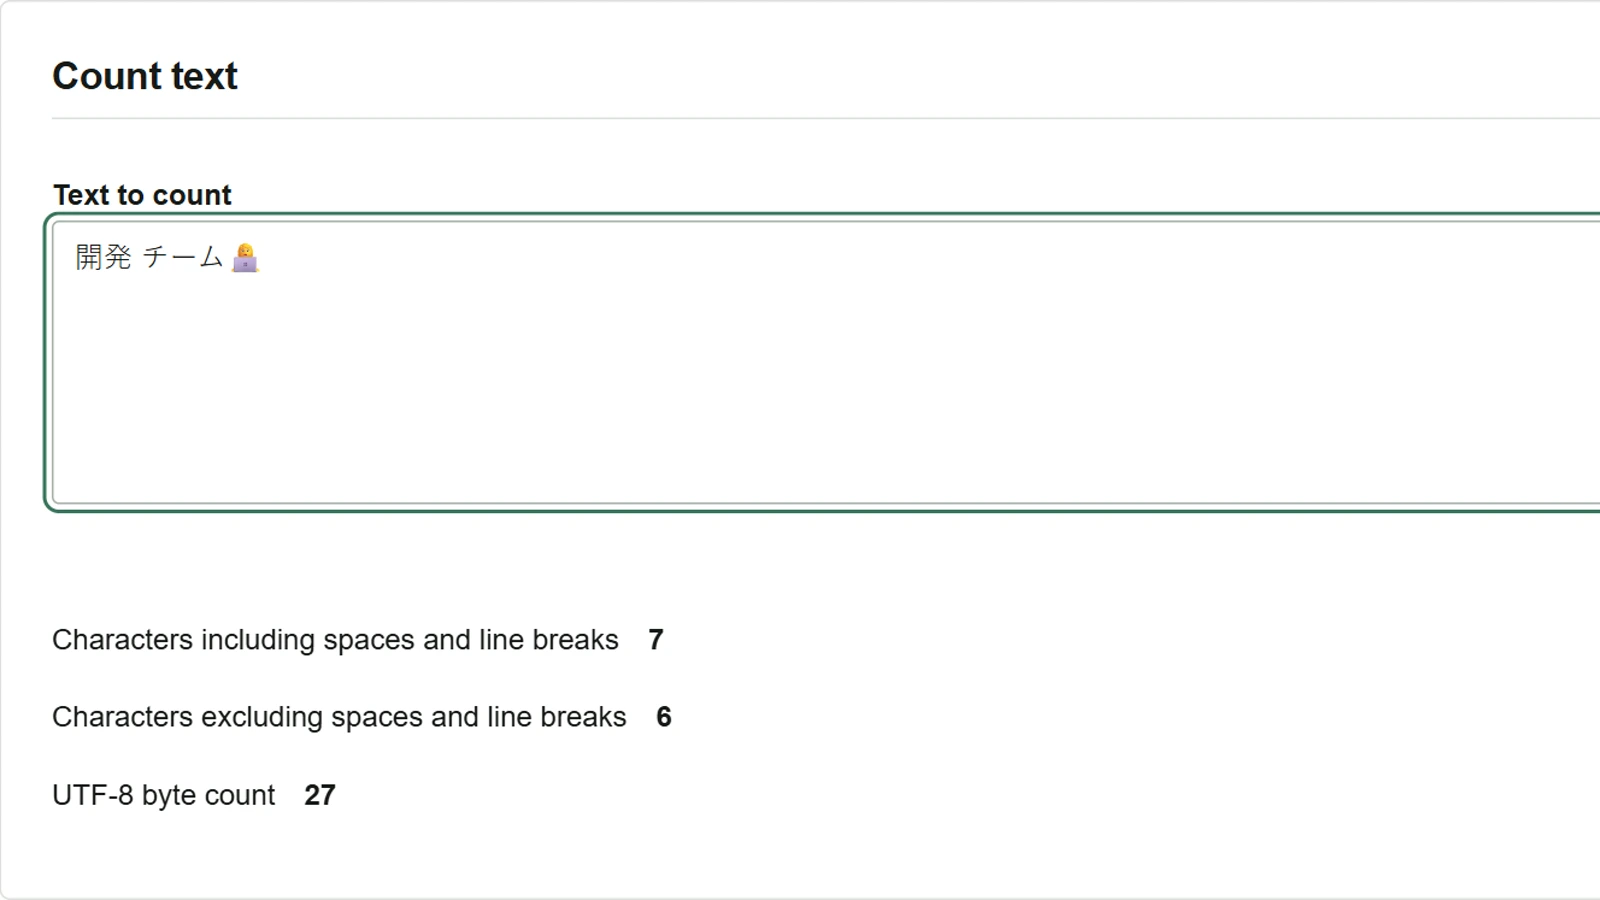
CSVの取り込み先から「項目名は UTF-8 で24バイトまで」と指定されたとする。候補の「開発 チーム👩💻」は、空白を含めて7文字だが、UTF-8 では27バイトになる。文字数カウンターを開き、どこまでが上限に収まるかを確認してから、文面を調整する。
24バイトに収まる先頭部分を確認する
- 「数えたい文章」に
開発 チーム👩💻を貼り付ける。空白込みは7文字、空白を除くと6文字、UTF-8 は27バイトと表示される。 - 「バイト数の上限(任意)」に
24と入力する。元の文面が3バイト超過していることと、上限内に収まる先頭部分の「開発 チーム」が表示される。 - 先頭部分をそのまま使う場合は、結果欄のテキストを選んでコピーする。元の入力欄には、絵文字付きの文面が残る。
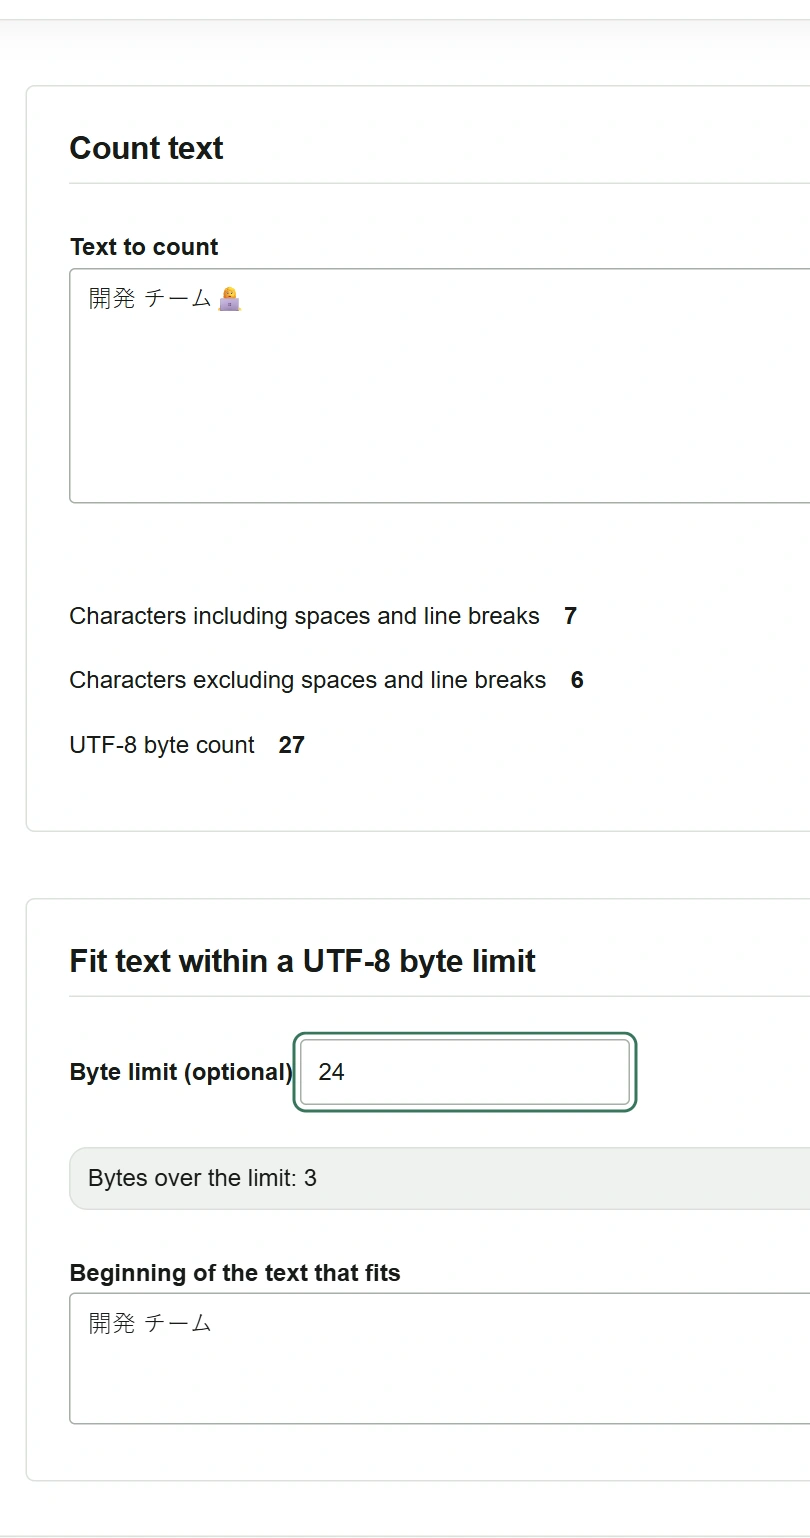
「開発 チーム」までで16バイトあり、その直後の 👩💻 は画面上で1文字と数えるが、複数のコードポイントで構成されていて11バイトを使う。ツールはこのまとまりを分断せず、収まる位置までの先頭部分を表示する。
絵文字を残して文面を調整する
- 上限を
24のままにして、最初の入力欄を開発班👩💻に置き換える。 - UTF-8 のバイト数は20、上限までの残りは4バイトになる。収まる先頭部分の欄には、修正後の文面全体が表示される。
- 文面をコピーして取り込み先へ貼り付け、取り込み先でも受け付けられることを確認する。
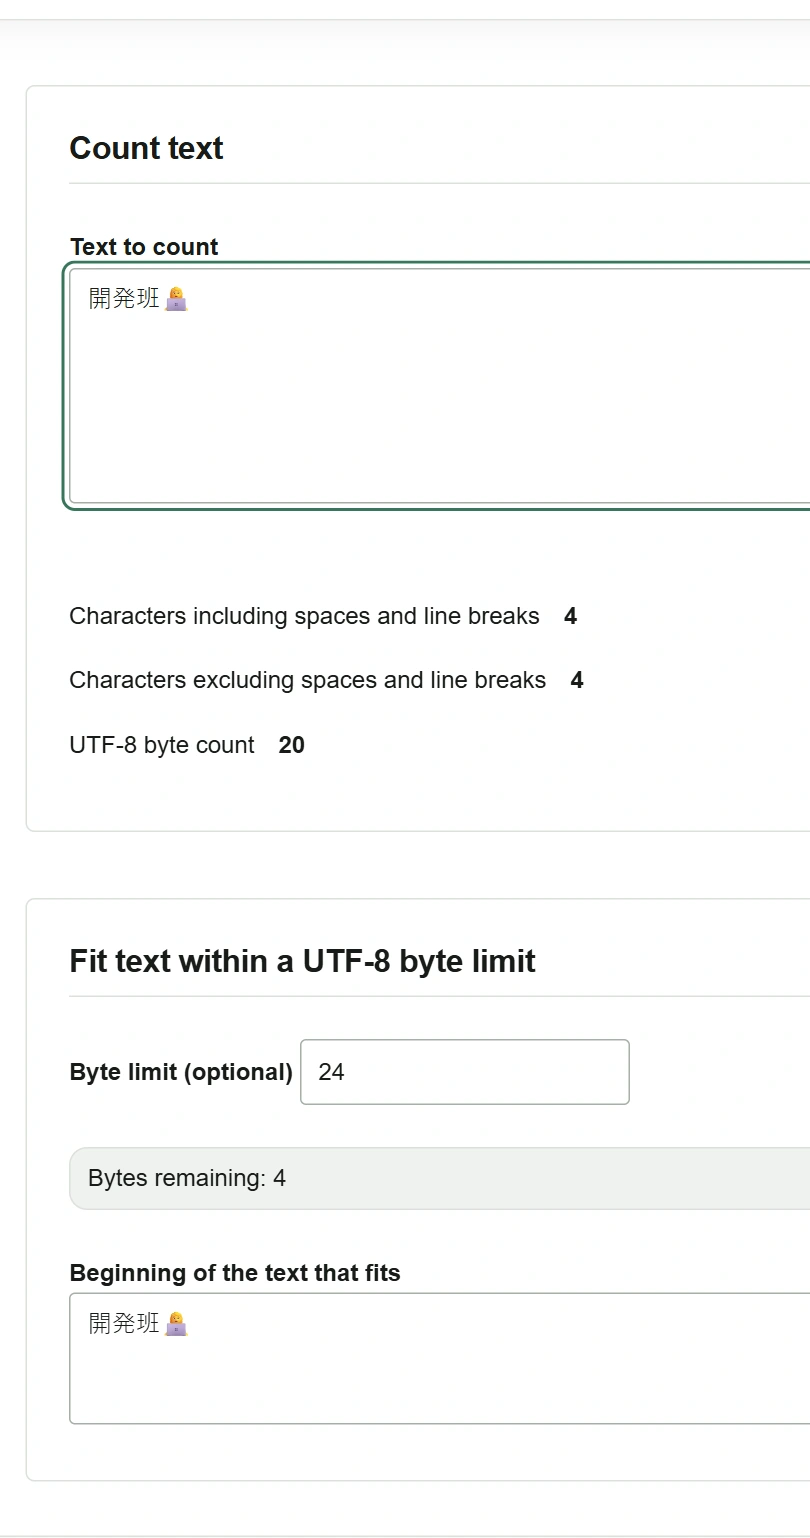
この例で数えたのは UTF-8 で保存する項目の値である。CSV の区切り文字や、書き出し時に付く引用符も含めたファイルサイズを確認する場合は、保存したファイルを計測する。テキスト欄に貼り付けた改行は LF として1バイトで数えるため、CRLF で保存したファイルでは改行1か所につき2バイトになる。取り込み先が別の文字コードや独自の文字数ルールを使う場合は、その仕様に従う。