Comprueba un límite de bytes UTF-8 con el contador de caracteres
Con capturas de pantalla, comprueba un límite de 24 bytes UTF-8 para un campo CSV, encuentra qué parte cabe sin cortar un emoji y acorta el texto para conservarlo.
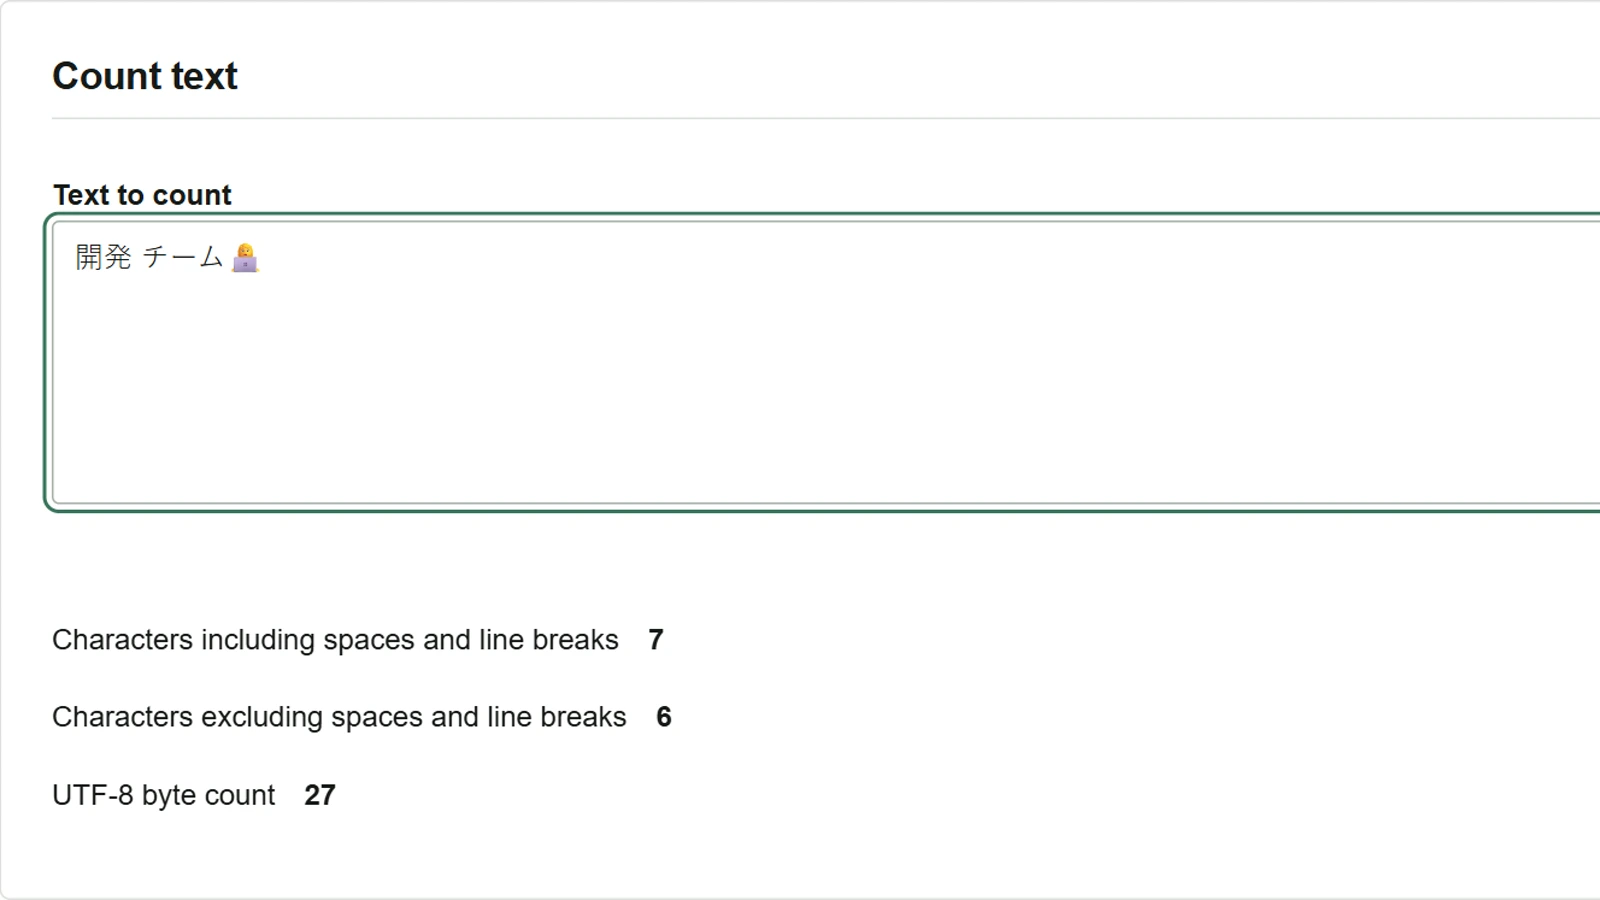
Supongamos que un importador de CSV admite nombres de campo de hasta 24 bytes en UTF-8. La propuesta 開発 チーム👩💻 tiene siete caracteres con el espacio, pero ocupa 27 bytes. Abre el contador de caracteres para ver qué parte cabe antes de ajustar el texto.
Encuentra el comienzo que cabe en 24 bytes
- Pega
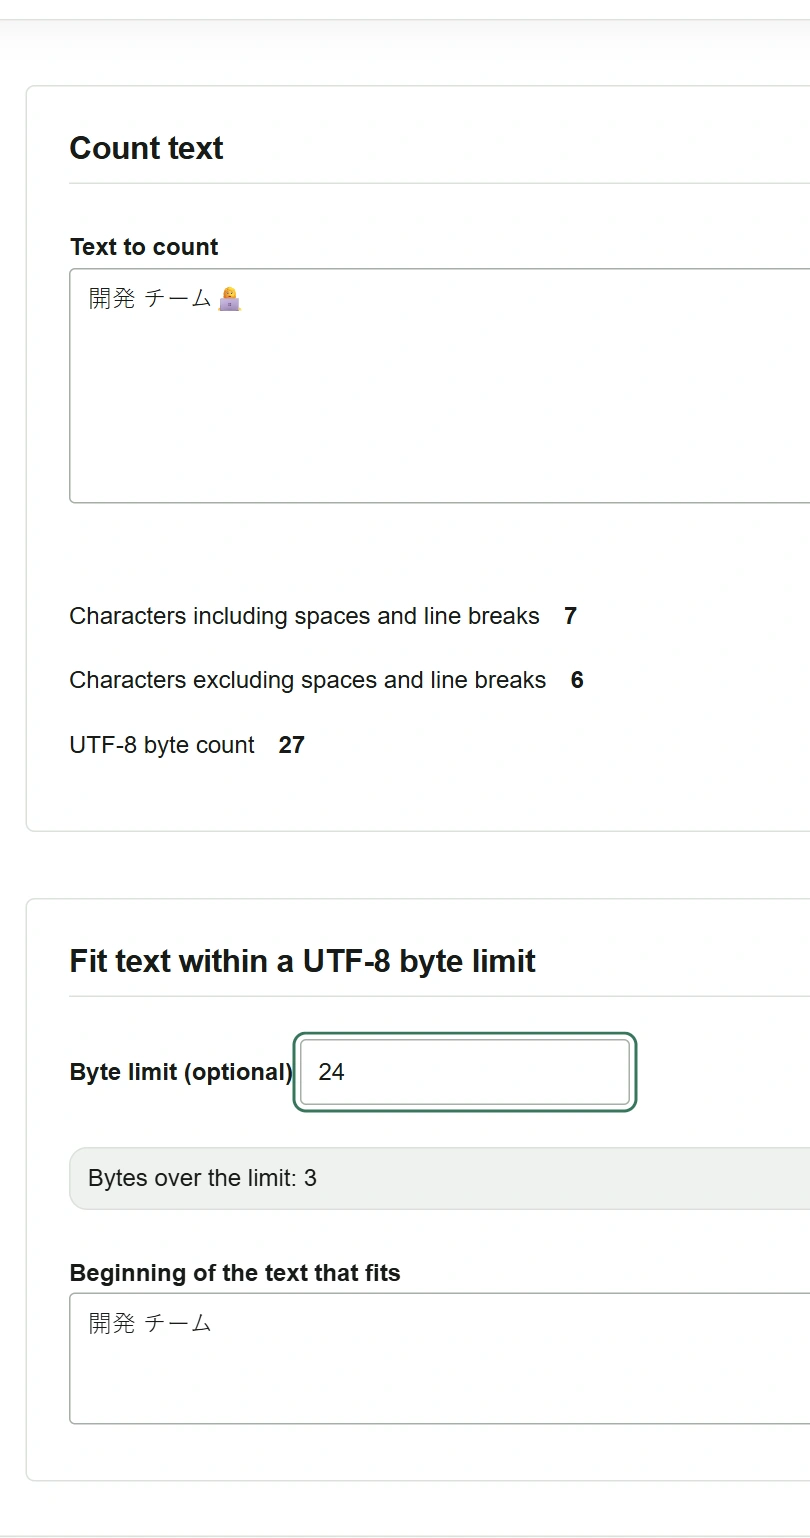
開発 チーム👩💻en Texto que quieres contar. Comprueba que hay siete caracteres con el espacio, seis sin él y 27 bytes UTF-8. - Escribe
24en Límite de bytes (opcional). - El texto original supera el límite por tres bytes. El campo de resultados muestra
開発 チーム. Para usar esa parte, selecciónala y cópiala. El texto original con el emoji sigue en el campo de entrada.
Acorta el texto y conserva el emoji
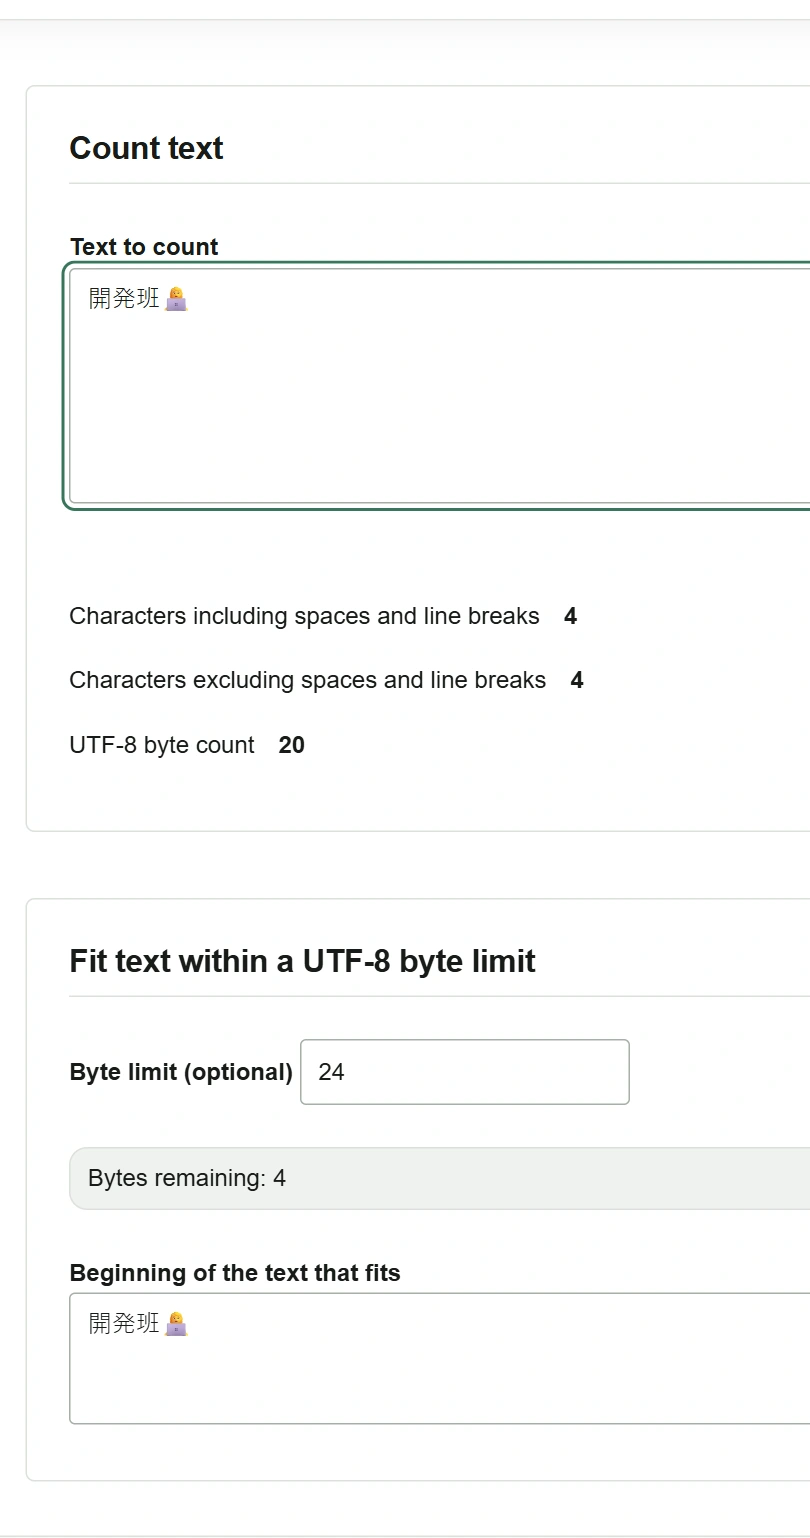
- Mantén el límite en
24y sustituye el contenido del primer campo por開発班👩💻. - El texto revisado ocupa 20 bytes y deja cuatro libres. El campo de resultados muestra el texto íntegro. Cópialo al destino y comprueba que se admite.
Aquí se mide el valor del campo codificado en UTF-8. Para incluir los separadores y las comillas añadidas al exportar, mide el archivo CSV guardado. Los saltos de línea pegados cuentan como un byte (LF). Un archivo guardado con CRLF usa dos bytes por salto. Sigue las reglas del importador si usa otra codificación u otro método de recuento.