Jak ověřit limit bajtů UTF-8 pomocí počítadla znaků
Snímky obrazovky ukazují, jak ověřit limit 24 bajtů UTF-8 pro název v CSV, najít začátek bez rozdělení emoji a zkrátit text tak, aby emoji zůstalo.
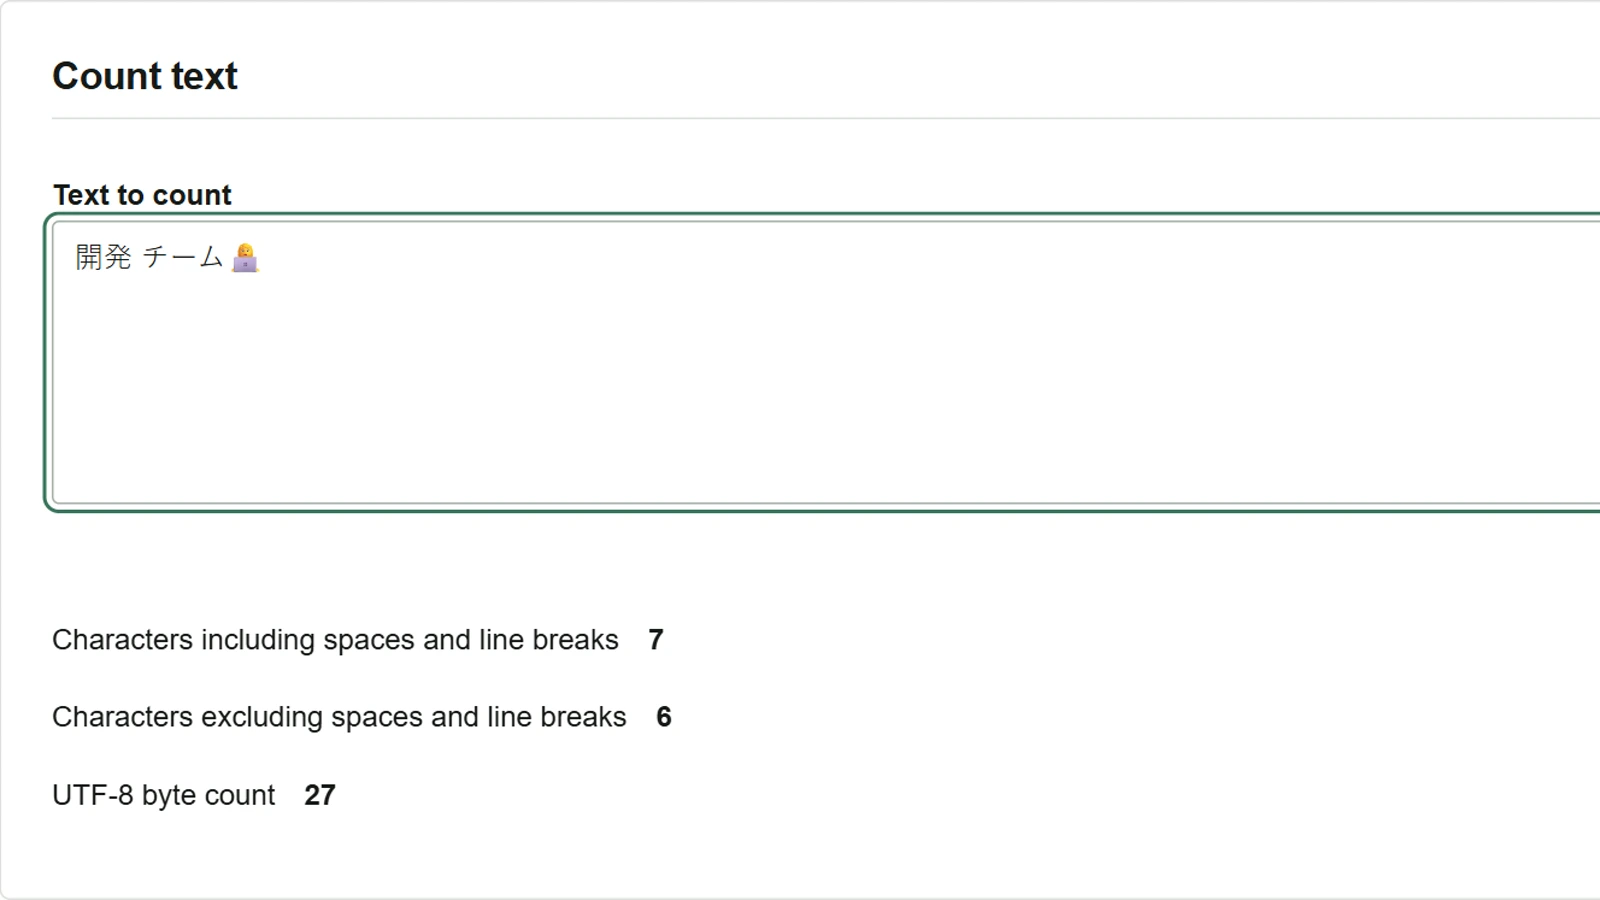
Předpokládejme, že nástroj pro import CSV dovoluje v názvu pole nejvýše 24 bajtů v UTF-8. Navržený název 開発 チーム👩💻 má sedm znaků včetně mezery, ale zabírá 27 bajtů. Otevřete nástroj počítadlo znaků a před úpravou zjistěte, která část se vejde.
Najděte začátek, který se vejde do 24 bajtů
- Vložte
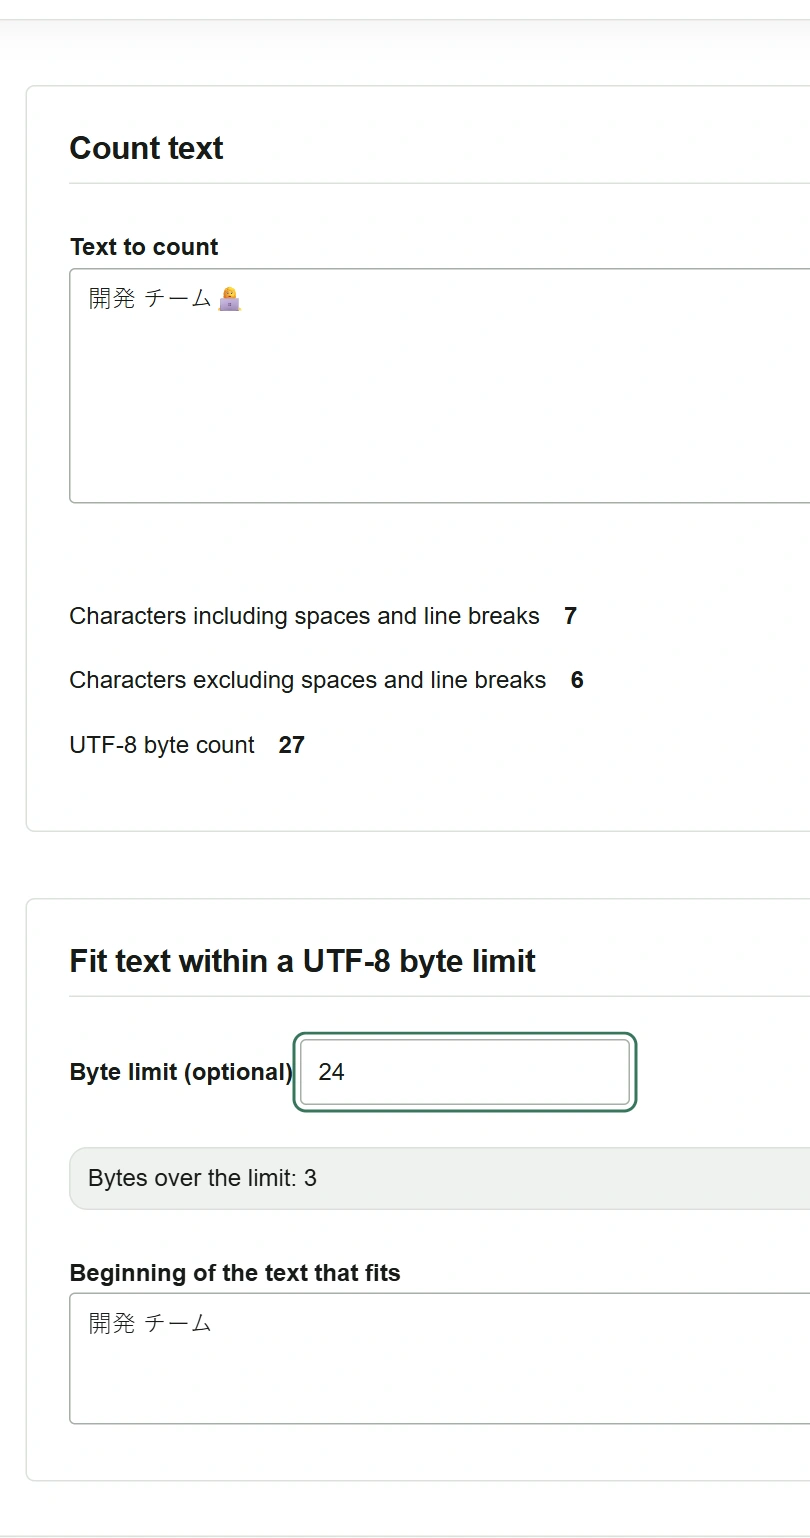
開発 チーム👩💻do pole Text k počítání. Ověřte sedm znaků s mezerou, šest bez mezery a 27 bajtů v UTF-8. - Do pole Limit bajtů (volitelný) zadejte
24. - Původní text překračuje limit o tři bajty. V poli s výsledkem se zobrazí
開発 チーム. Chcete-li tuto část použít, označte ji a zkopírujte. Původní text s emoji zůstane ve vstupním poli.
Zkraťte text a zachovejte emoji
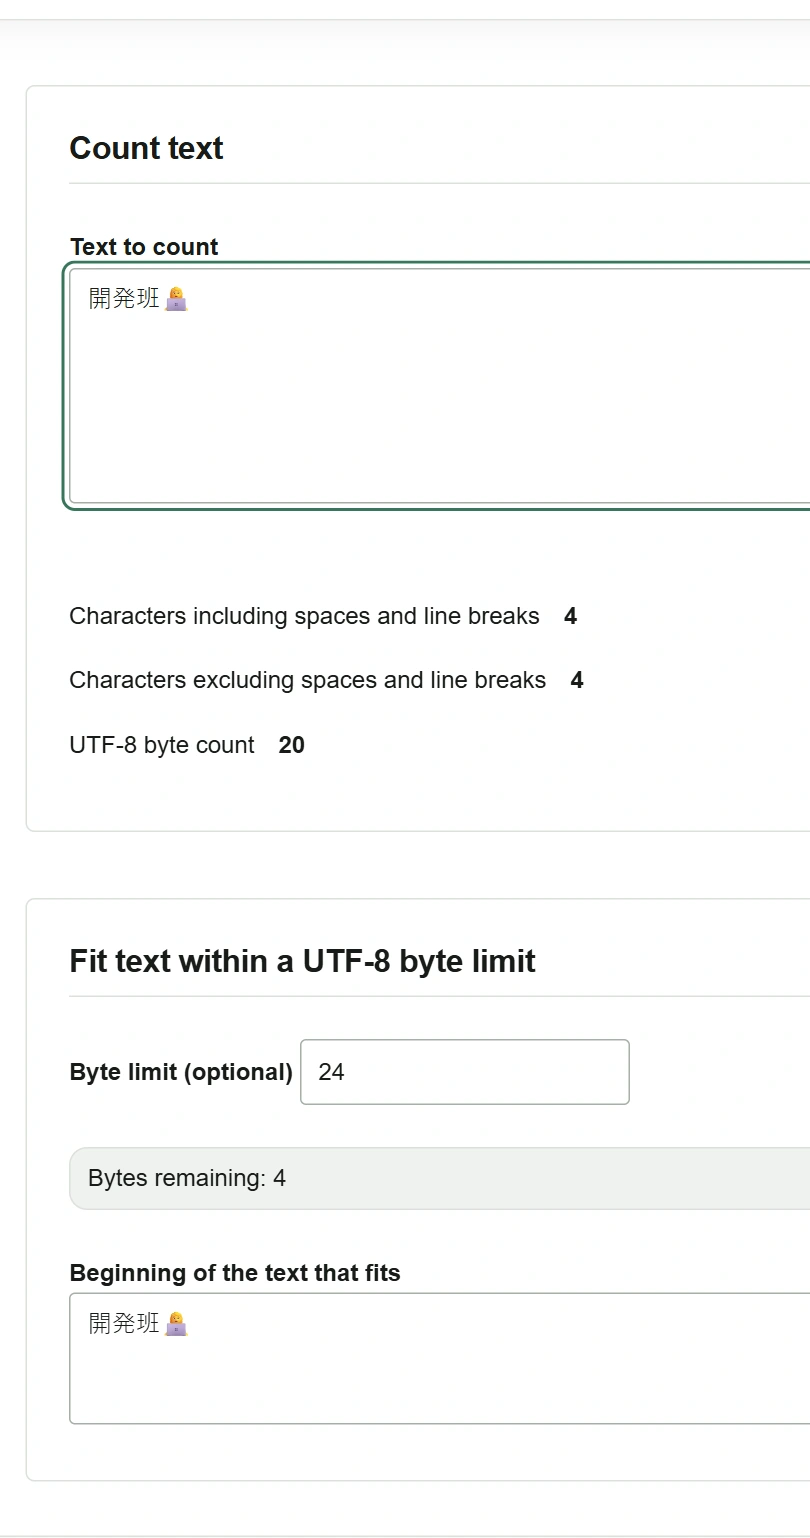
- Ponechte limit
24a nahraďte text v prvním poli výrazem開発班👩💻. - Upravený text zabírá 20 bajtů a zbývají čtyři. V poli s výsledkem je celý text. Zkopírujte jej na cílové místo a ověřte, že jej import přijme.
V příkladu měříme hodnotu pole v UTF-8. Pokud chcete započítat oddělovače CSV a uvozovky přidané při exportu, změřte uložený soubor. Vložený konec řádku zabírá jako LF jeden bajt, zatímco v souboru uloženém s CRLF zabírá dva. Používá-li import jiné kódování nebo způsob počítání znaků, řiďte se jeho pravidly.