正規表現で複数行の商品コードを抽出する
商品コードの一覧から、SKU-に数字4桁が続く行だけを正規表現で抽出する。ブラウザの正規表現テスターで、各行の先頭と末尾を照合するm、全件を探すg、結果に付く開始位置の読み方を画面付きで紹介する。
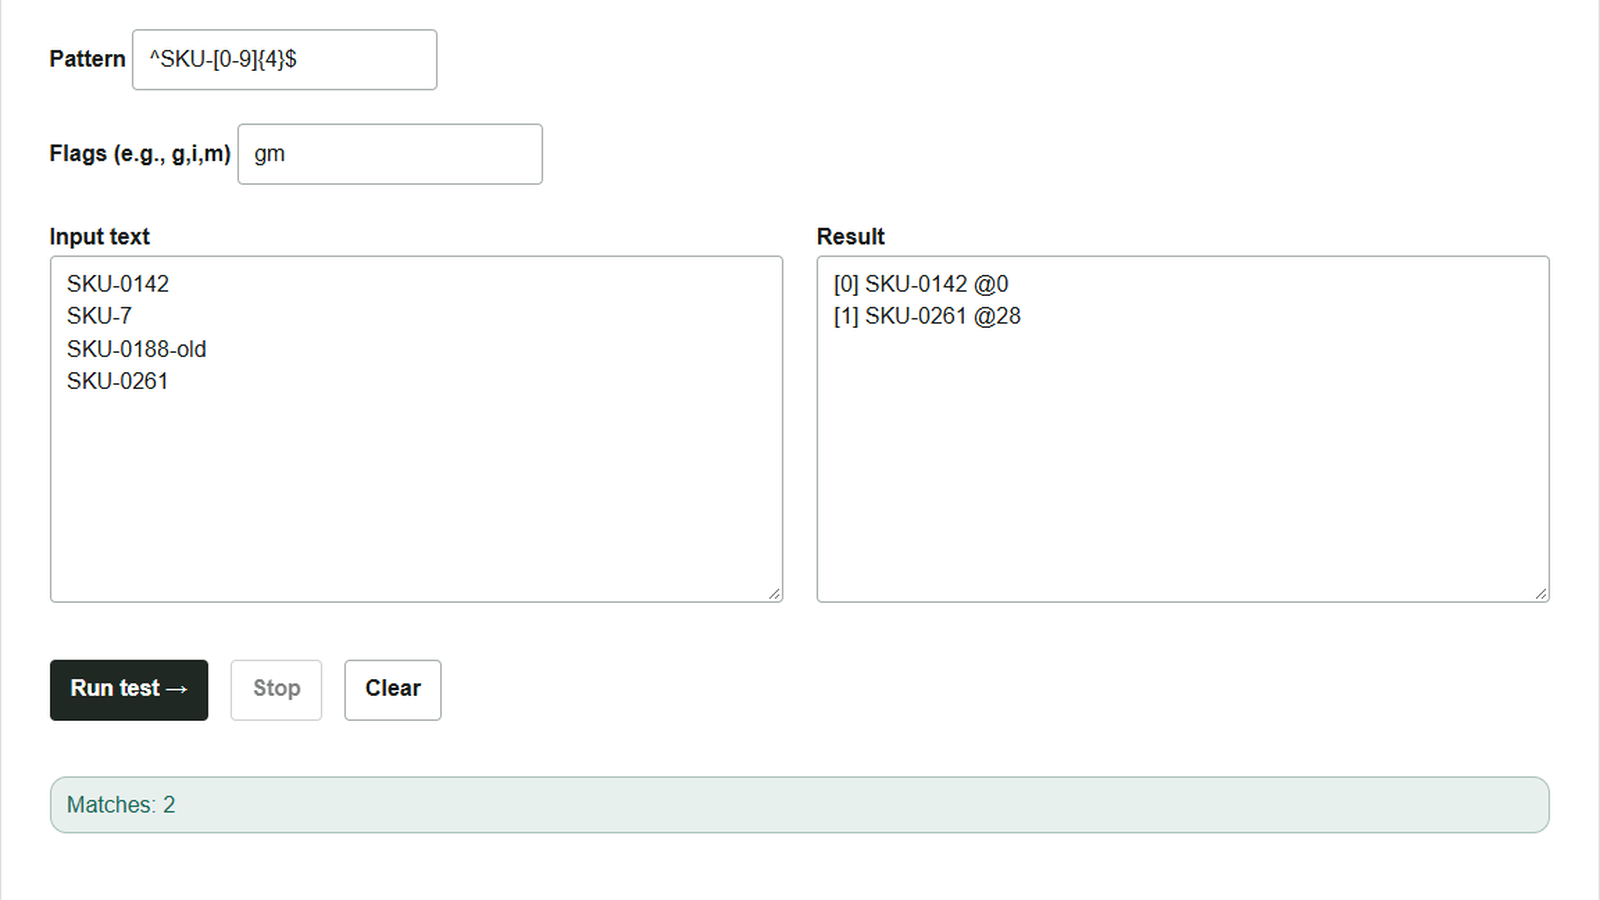
棚卸し用の一覧に、通常の商品コードと旧形式のコードが混ざっている。今回拾いたいのは、1行に半角の「SKU-」と数字4桁だけが並ぶコードだ。正規表現テスター で、桁数が足りない行や末尾に注記が付いた行を除外できるか確かめる。
商品コードだけが書かれた行を探す
「入力テキスト(Input text)」に、次の架空の一覧を貼り付ける。
SKU-0142
SKU-7
SKU-0188-old
SKU-0261
- 「正規表現(Pattern)」に
^SKU-[0-9]{4}$を入力する。正規表現を囲むスラッシュは入力しない。 - 「フラグ(Flags)」に
gmを入力する。mを付けると^と$が各行の先頭と末尾にも一致する。gは一致を先頭から順に探す指定である。 - 「テスト実行(Run test)」を押す。「結果(Result)」に
SKU-0142とSKU-0261が出る。SKU-7は数字が1桁で、SKU-0188-oldは4桁の直後に行末が来ないため、どちらも一致しない。
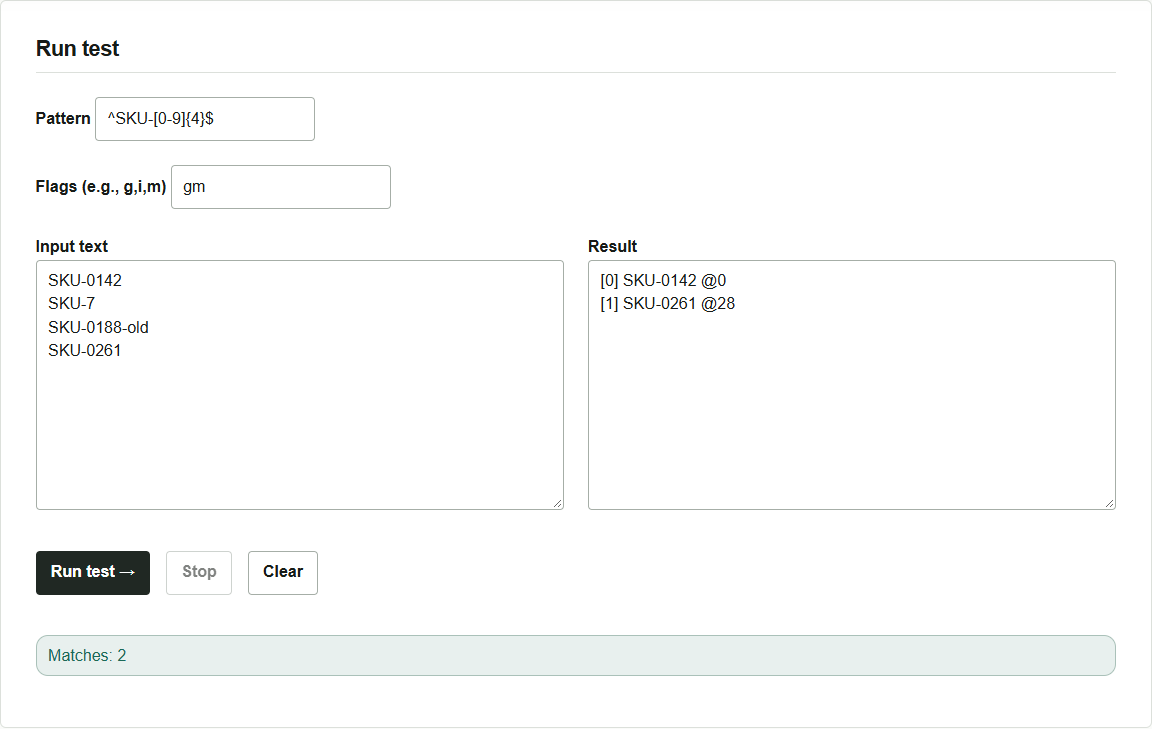
結果の [0] と [1] は、0から数えた一致の順番である。@ に続く数字は、入力全体の先頭を0とした開始位置だ。2件目の @28 は、改行も含めて先頭から28文字分進んだ位置にコードがあることを示す。位置は JavaScript の UTF-16 コード単位で数えるので、たとえば絵文字の 📦 は2単位として数えられる。
フラグを外して結果を比べる
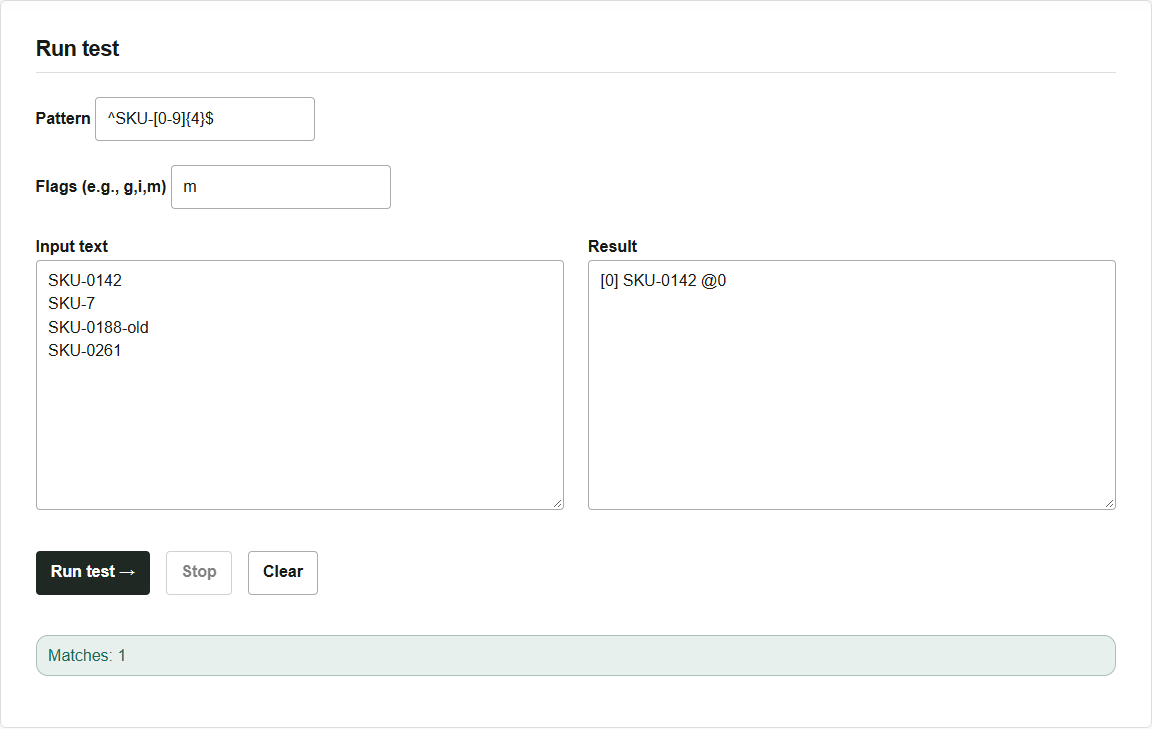
フラグの g だけを外し、m で実行すると、1件目の SKU-0142 だけが表示される。2件目以降も確認したいときは gm に戻す。逆に m だけを外して g にすると、^ と $ が入力全体の両端を指すため、この4行の例で一致する箇所はない。
抽出結果は元のテキストを変更せず、結果欄から選択してコピーできる。長い一覧では表示が最大2,000件に制限され、結果の文字数上限でも打ち切られる。結果の打ち切りが表示された場合は、一覧を分けて個別に照合する。ツールはブラウザの JavaScript の正規表現を使うため、他の言語やエディターに同じ式を移すときは、使える構文やフラグをその環境でも確かめる。