用正则表达式提取多行商品代码
从商品代码列表中仅提取 SKU- 后接四位数字的行。通过浏览器截图说明匹配每行边界的 m、查找全部匹配的 g,以及结果中的起始位置。
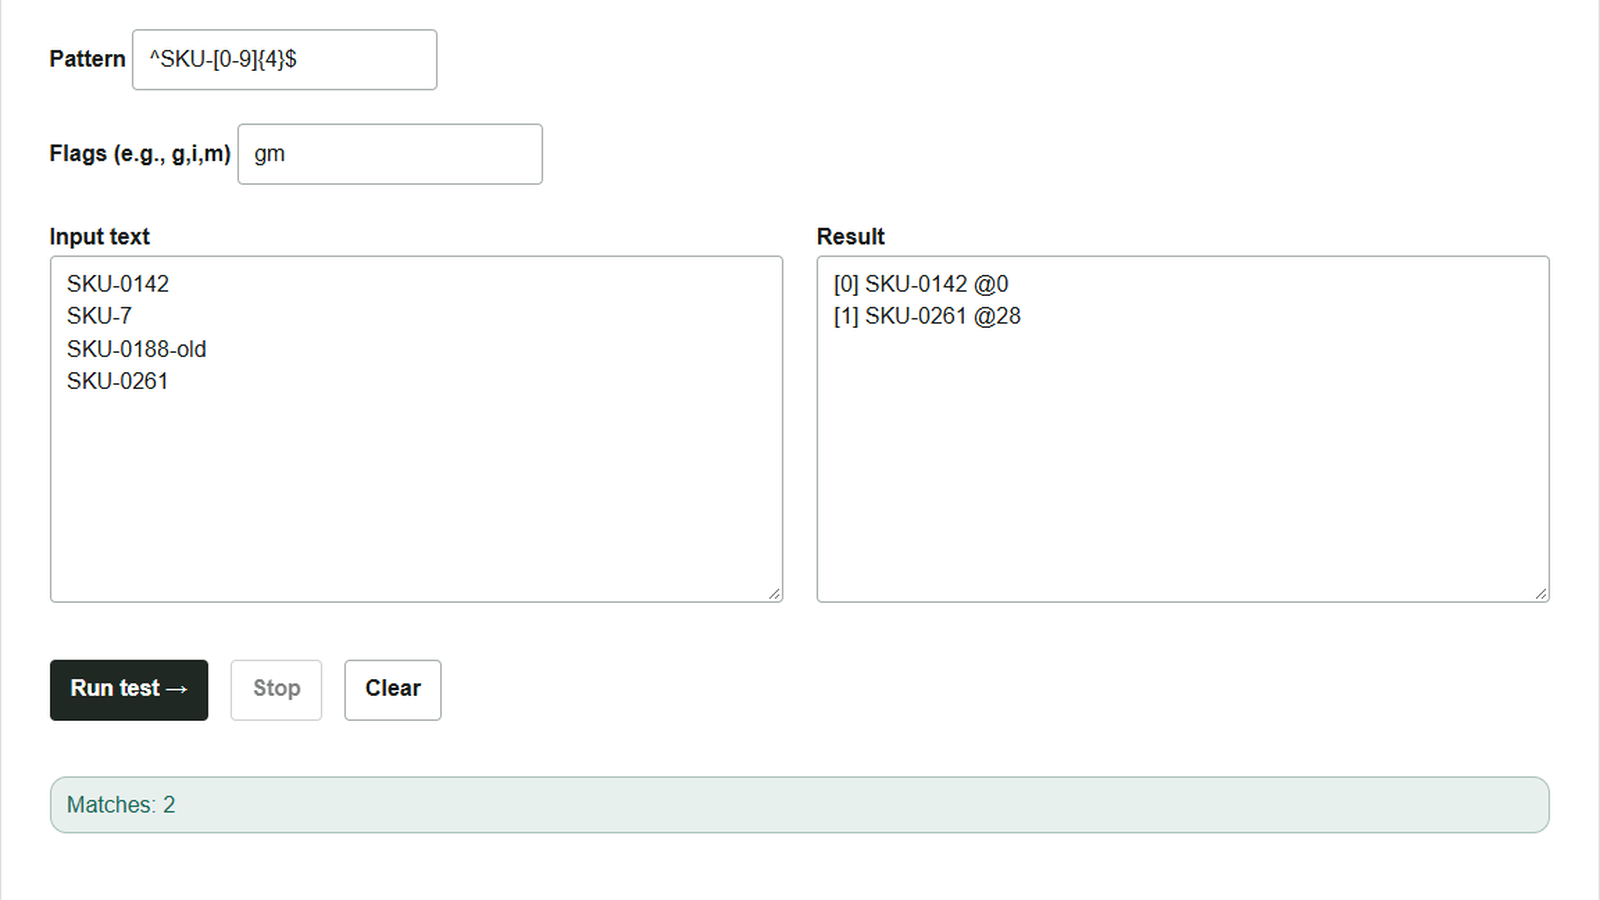
盘点列表中混有当前商品代码和旧格式的代码。本次要提取的是一行中只有 ASCII 前缀 SKU- 和四位数字的代码。用正则表达式测试器检查能否排除位数不足或末尾带有备注的行。
查找只包含商品代码的行
将以下虚构列表粘贴到输入文本中。
SKU-0142
SKU-7
SKU-0188-old
SKU-0261
- 在正则表达式中输入
^SKU-[0-9]{4}$。不要输入用于包围正则表达式的斜杠。 - 在标志中输入
gm。添加m后,^和$也会匹配每行的开头和结尾。g表示从开头依次查找匹配项。 - 点击执行测试。结果中出现
SKU-0142和SKU-0261。SKU-7只有一位数字,而SKU-0188-old的四位数字后并未立即结束该行,所以都不匹配。
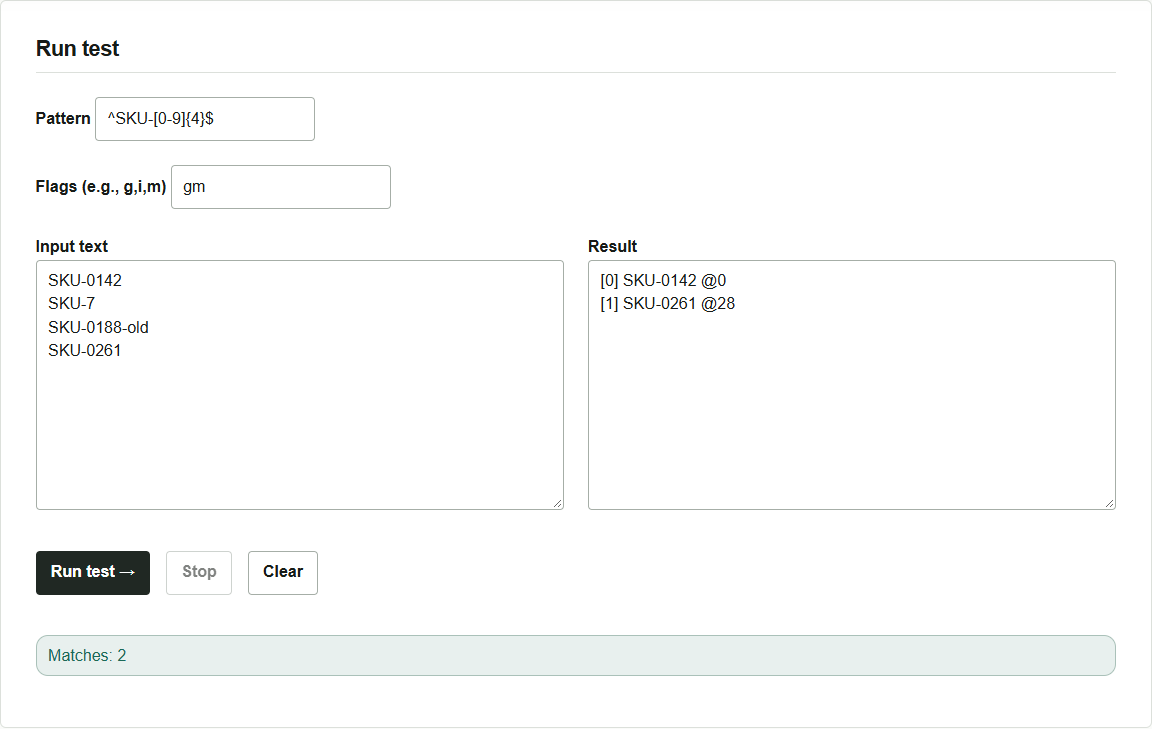
结果中的 [0] 和 [1] 是从 0 开始计数的匹配顺序。@ 后面的数字是以整个输入的开头为 0 的起始位置。第二项的 @28 表示将换行也计算在内,代码从第 28 个单位偏移处开始。位置按照 JavaScript 的 UTF-16 代码单元计数,例如表情符号 📦 占两个单位。
移除标志并比较结果
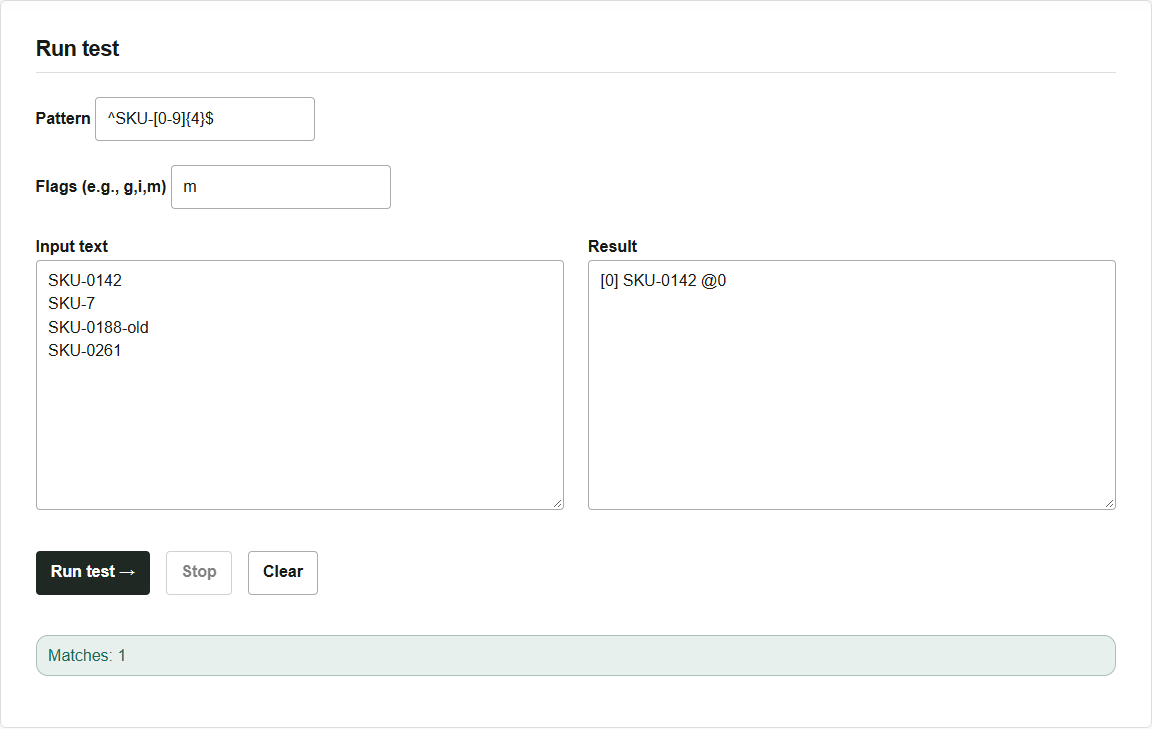
只移除 g,以 m 运行时,仅显示第一项 SKU-0142。要查看后续匹配,请恢复为 gm。反过来,如果只移除 m,留下 g,^ 和 $ 就指向整个输入的两端,因此这四行示例没有匹配项。
提取不会修改原文,可以在结果字段中选择并复制内容。长列表最多显示 2,000 个匹配项,达到结果字符数上限时也会停止输出。如果出现结果已截断的提示,请将列表拆分后分别检查。工具使用浏览器的 JavaScript 正则表达式;将同一表达式移到其他语言或编辑器时,也要确认目标环境支持的语法和标志。