रेगुलर एक्सप्रेशन से कई पंक्तियों में से उत्पाद कोड निकालें
केवल SKU- के बाद चार अंक वाली पंक्तियाँ निकालें। स्क्रीनशॉट में हर पंक्ति की सीमा के लिए m, सभी मेल के लिए g और परिणाम की शुरुआती स्थिति समझाई गई है।
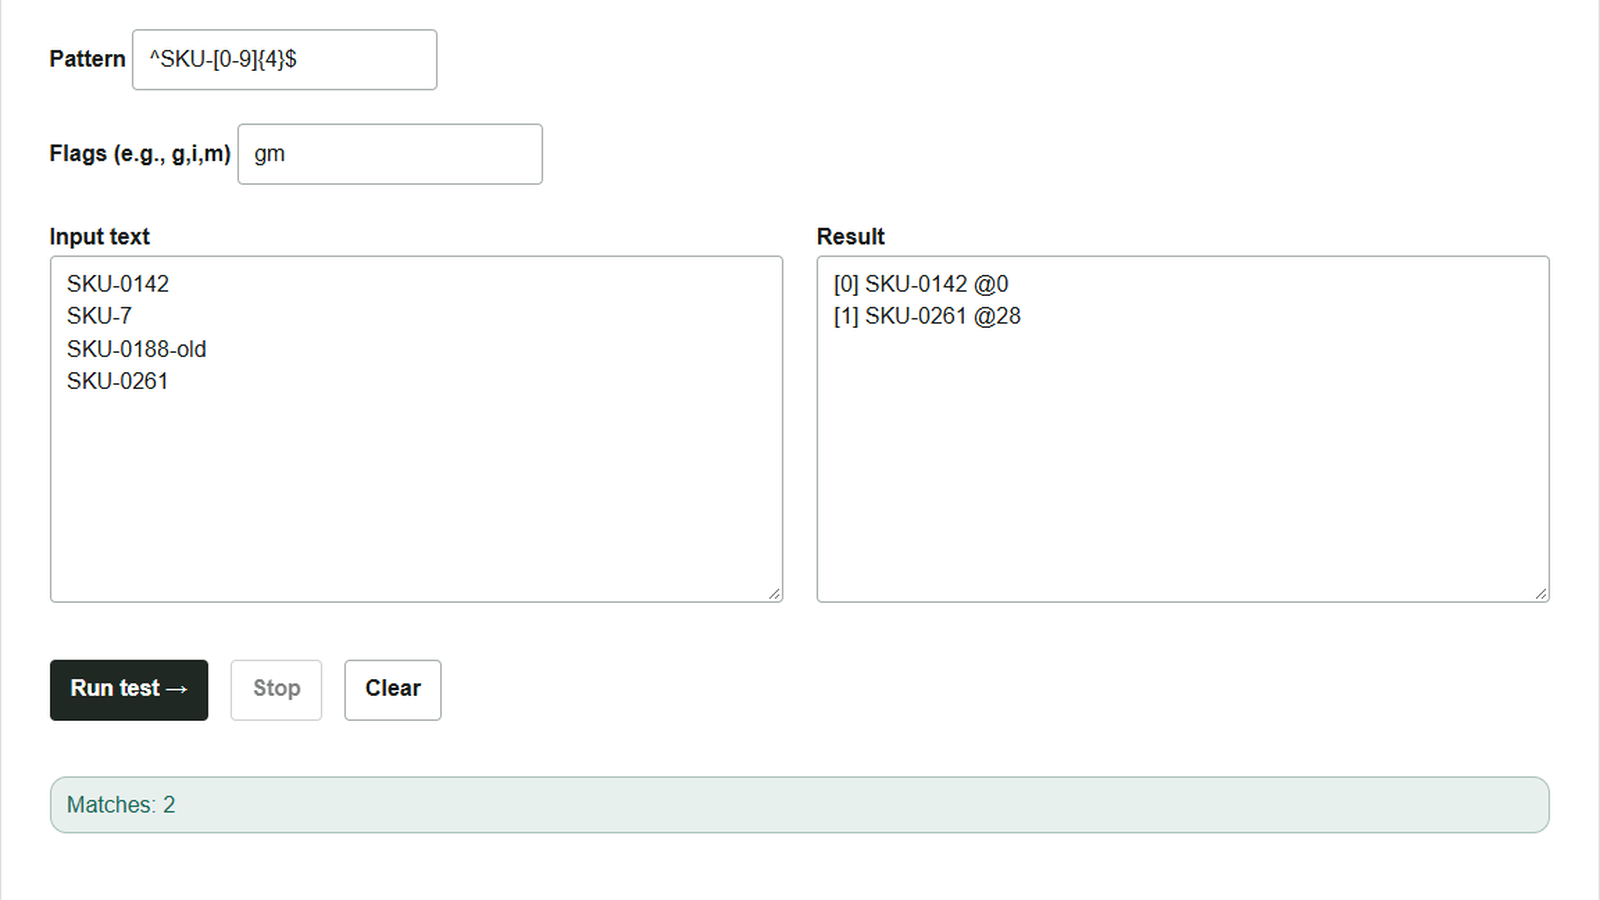
स्टॉक की सूची में सामान्य उत्पाद कोड और पुराने फ़ॉर्मेट के कोड मिले हुए हैं। इस बार केवल वे पंक्तियाँ चाहिए जिनमें ASCII उपसर्ग SKU- के बाद चार अंक हों और कुछ नहीं। Regex टेस्टर से जाँचें कि कम अंक वाली या अंत में टिप्पणी वाली पंक्तियाँ बाहर रह जाती हैं या नहीं।
केवल उत्पाद कोड वाली पंक्तियाँ खोजें
इनपुट टेक्स्ट में यह काल्पनिक सूची चिपकाएँ।
SKU-0142
SKU-7
SKU-0188-old
SKU-0261
- पैटर्न में
^SKU-[0-9]{4}$लिखें। रेगुलर एक्सप्रेशन के आसपास लगाए जाने वाले स्लैश शामिल न करें। - फ्लैग में
gmलिखें।mलगाने पर^और$हर पंक्ति के आरंभ तथा अंत से भी मेल खाते हैं।gशुरुआत से क्रमवार सभी मेल खोजता है। - टेस्ट चलाएँ दबाएँ। परिणाम में
SKU-0142औरSKU-0261दिखाई देते हैं।SKU-7में केवल एक अंक है औरSKU-0188-oldमें चार अंकों के तुरंत बाद पंक्ति समाप्त नहीं होती, इसलिए दोनों मेल नहीं खाते।
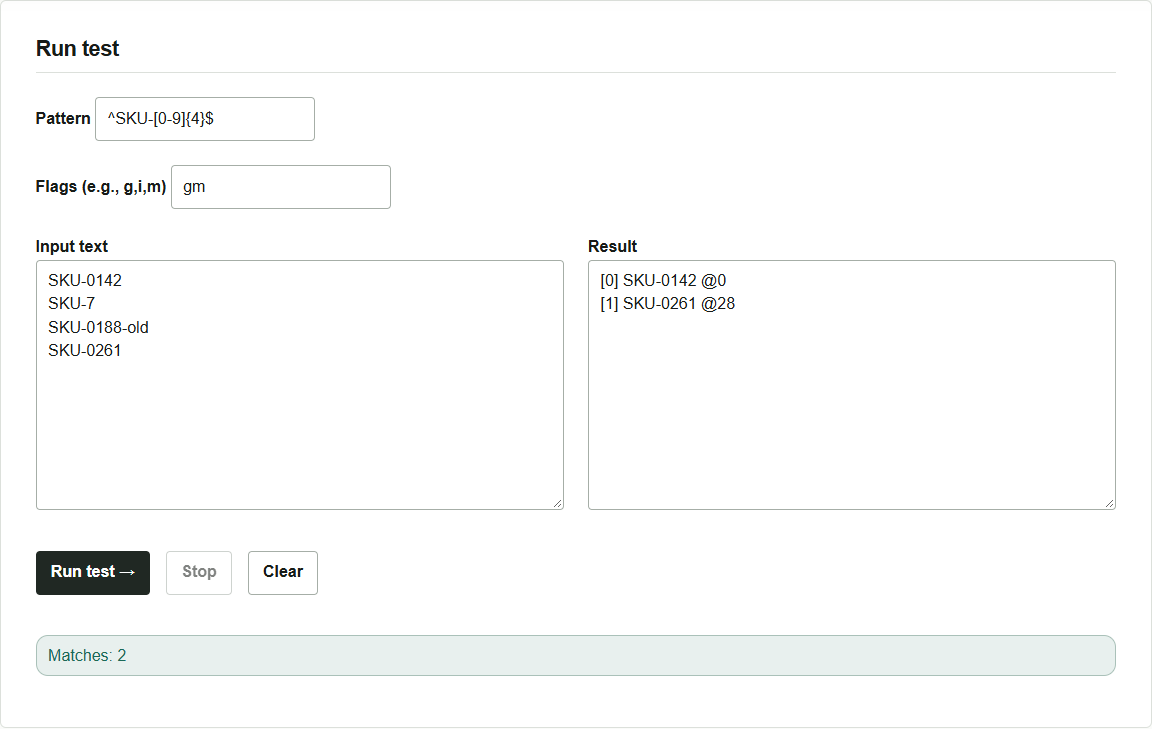
परिणाम में [0] और [1] शून्य से गिना गया मेल का क्रम है। @ के बाद की संख्या शुरुआती स्थिति बताती है, जिसमें पूरे इनपुट का आरंभ शून्य माना जाता है। दूसरे मेल का @28 बताता है कि पंक्ति विराम समेत शुरुआत से 28 इकाइयाँ आगे वह कोड है। स्थिति JavaScript की UTF-16 कोड इकाइयों में गिनी जाती है; उदाहरण के लिए 📦 इमोजी दो इकाइयाँ लेता है।
फ्लैग हटाकर परिणाम की तुलना करें
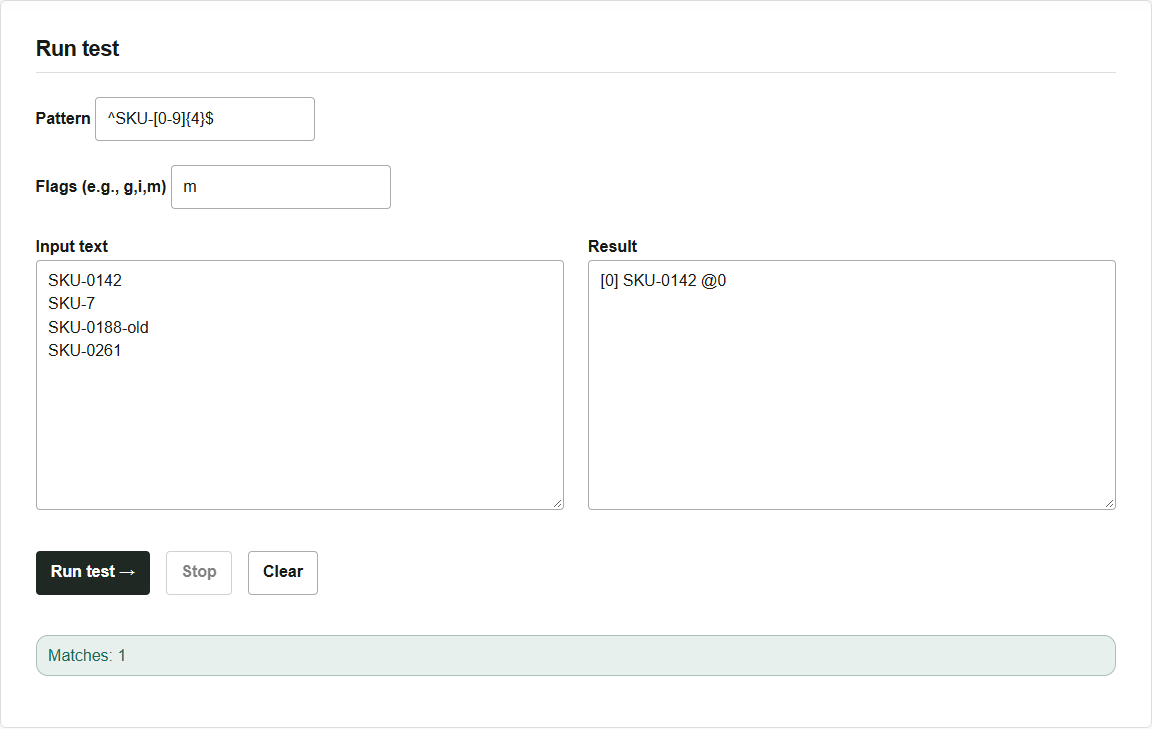
केवल g हटाकर m से चलाने पर पहला मेल SKU-0142 ही दिखता है। बाद के मेल देखने के लिए वापस gm करें। इसके उलट, केवल m हटाकर g रहने दें, तो ^ और $ पूरे इनपुट के दोनों सिरों को दर्शाते हैं। इसलिए इस चार-पंक्ति वाले उदाहरण में कोई मेल नहीं मिलता।
निकालने की प्रक्रिया मूल टेक्स्ट नहीं बदलती। परिणाम वाले फ़ील्ड से टेक्स्ट चुनकर कॉपी किया जा सकता है। लंबी सूची में अधिकतम 2,000 मेल दिखाए जाते हैं और परिणाम की कैरेक्टर सीमा पर भी आउटपुट रुक जाता है। परिणाम काटे जाने का संदेश आए, तो सूची को बाँटकर हर भाग की अलग जाँच करें। टूल ब्राउज़र के JavaScript रेगुलर एक्सप्रेशन का उपयोग करता है। यही पैटर्न किसी दूसरी भाषा या एडिटर में ले जाते समय वहाँ उपलब्ध सिंटैक्स और फ्लैग भी जाँचें।